एआई भाषा मॉडल डेटा सेंटर के क्षेत्रीय विस्तार को बढ़ावा दे रहे हैं
स्रोत:इंडियन एक्सप्रेस ↗
क्यों मायने रखता है
वैश्विक तकनीकी परिदृश्य में भारत की विकास यात्रा को समझने के लिए AI विकास, भाषाई विविधता और डिजिटल इंफ्रास्ट्रक्चर के अंतर्संबंधों को समझना महत्वपूर्ण है। यह अमूर्त तकनीकी लक्ष्यों (स्वदेशी AI) को समर्थन देने के लिए आवश्यक भौतिक बुनियादी ढांचे की आवश्यकताओं (डेटा सेंटर) पर प्रकाश डालता है, जो IT, इंफ्रास्ट्रक्चर और स्वदेशी तकनीक विकास से संबंधित GS3 विषयों के लिए अत्यधिक प्रासंगिक है।
सारांश
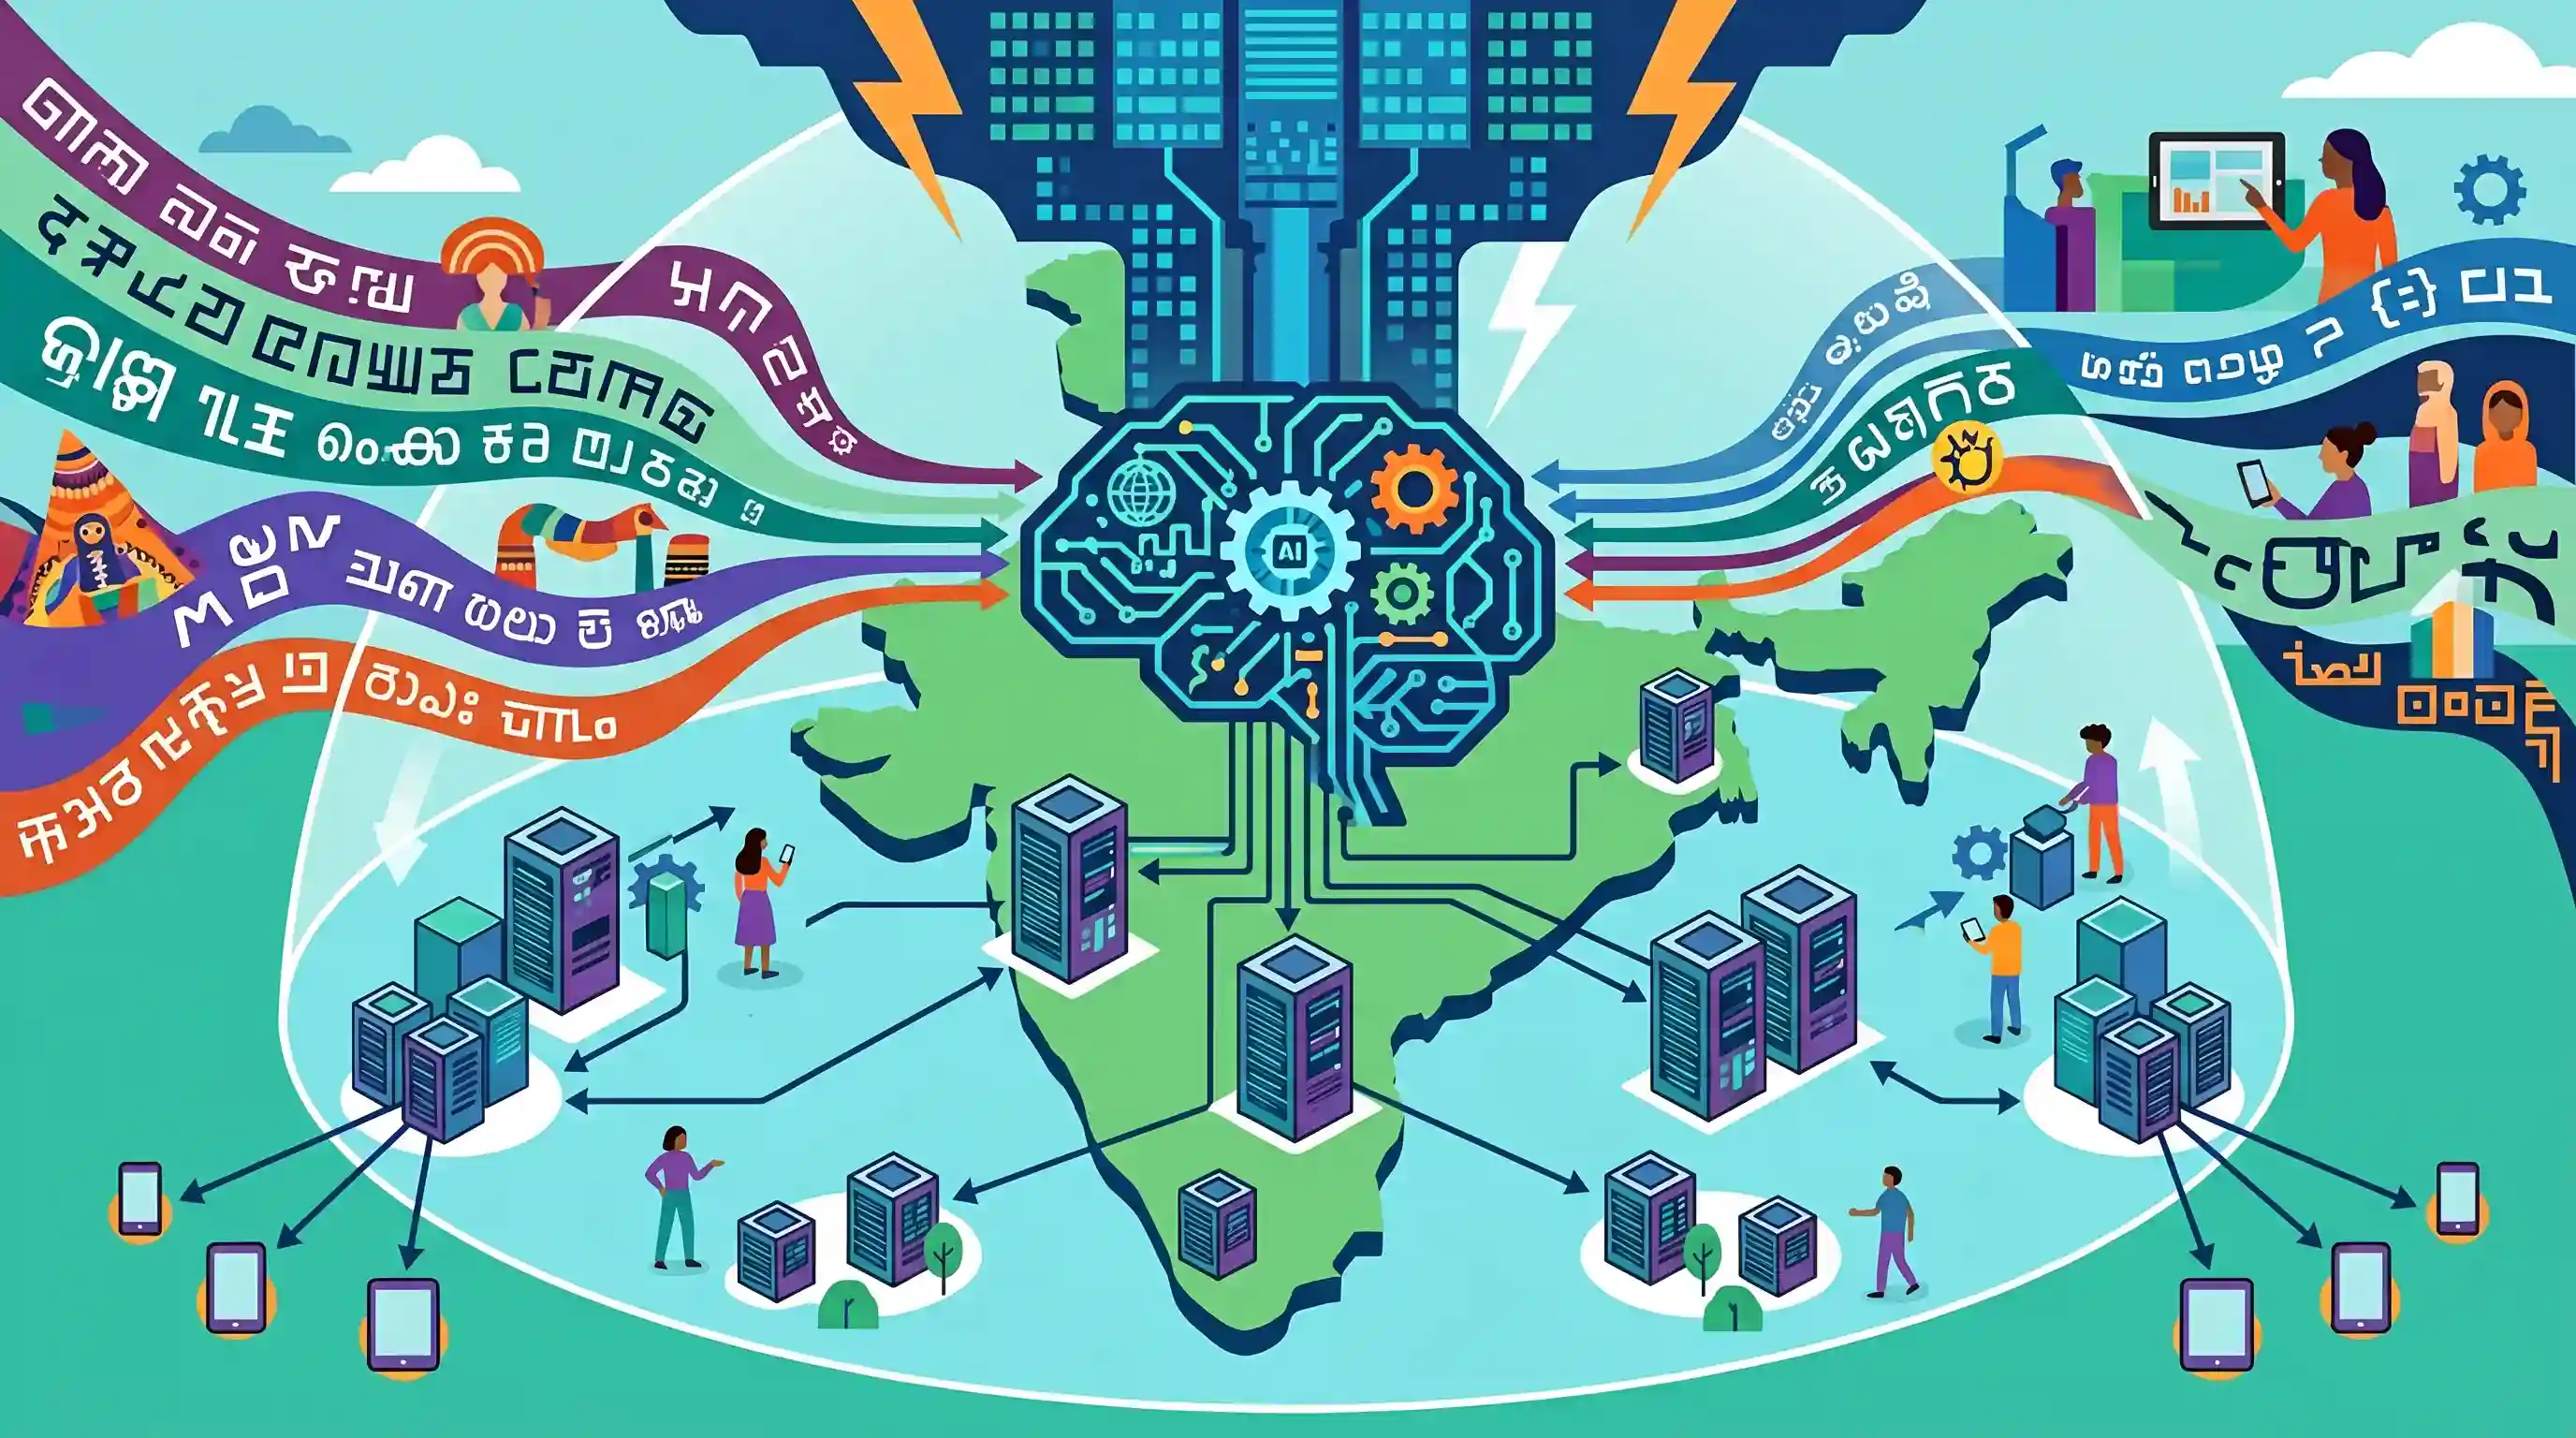
भारतीय संदर्भ के अनुरूप आर्टिफिशियल इंटेलिजेंस (AI) मॉडलों का विकास और प्रशिक्षण, विशेष रूप से देश की विविध क्षेत्रीय भाषाओं पर केंद्रित मॉडल, डेटा सेंटरों के विस्तार के लिए प्रमुख उत्प्रेरक होने की उम्मीद है। जैसे-जैसे स्वदेशी लार्ज लैंग्वेज मॉडल्स (LLMs) बनाने की पहल गति पकड़ रही है, उनकी भारी कम्प्यूटेशनल आवश्यकताएं मजबूत डिजिटल बुनियादी ढांचे की जरूरत को अनिवार्य बनाती हैं। यह मांग न केवल टियर-1 शहरों में, बल्कि विभिन्न क्षेत्रों में डेटा सेंटरों की स्थापना को बढ़ावा दे सकती है, जिससे डेटा स्थानीयकरण (data localization) को समर्थन मिलेगा, लेटेंसी (latency) कम होगी और 'डिजिटल इंडिया' के लक्ष्यों के अनुरूप एक विकेंद्रीकृत डिजिटल अर्थव्यवस्था को बढ़ावा मिलेगा।
मुख्य बिंदु
- भारतीय संदर्भ और क्षेत्रीय भाषाओं के अनुरूप विशेष रूप से तैयार किए गए आर्टिफिशियल इंटेलिजेंस (AI) मॉडल्स के प्रशिक्षण के लिए स्थानीयकृत कंप्यूटेशनल पावर में भारी वृद्धि की आवश्यकता है।
- स्थानीयकृत कंप्यूट (localized compute) की यह मांग प्रमुख महानगरीय केंद्रों से परे, पूरे भारत में डेटा केंद्रों के महत्वपूर्ण क्षेत्रीय विस्तार को गति देने के लिए अनुमानित है।
- भारत की भाषाई विविधता को संसाधित करने में सक्षम स्वदेशी लार्ज लैंग्वेज मॉडल (LLMs) विकसित करने के लिए डेटा को उसके स्रोत के करीब संसाधित और संग्रहीत करने की आवश्यकता है, जो डेटा स्थानीयकरण (data localization) की आवश्यकता को और अधिक पुख्ता करता है।
- डेटा सेंटर्स का क्षेत्रीय विस्तार न केवल IndiaAI मिशन और भाषिनी जैसी पहलों को समर्थन प्रदान करेगा, बल्कि स्थानीय डिजिटल अर्थव्यवस्थाओं को भी बढ़ावा देगा और अंतिम उपयोगकर्ताओं के लिए लेटेंसी (latency) को कम करेगा।
महत्वपूर्ण शब्द
इंडियाएआई मिशन

₹10,371 करोड़ के परिव्यय वाली एक व्यापक राष्ट्रीय पहल, जिसका उद्देश्य संप्रभु कंप्यूट इंफ्रास्ट्रक्चर (10,000+ GPUs), फाउंडेशनल मॉडल और डेटासेट सहित एक मजबूत AI इकोसिस्टम का निर्माण करना है।
UPSC context
GS प्रश्नपत्र III (विज्ञान एवं प्रौद्योगिकी/अर्थव्यवस्था)। यह संप्रभु तकनीकी क्षमता, डिजिटल संप्रभुता और हाई-टेक बुनियादी ढांचे के विकास के ज्ञान का परीक्षण करता है।
डिजिटल इंडिया
भारत को बेहतर बुनियादी ढांचे, ई-गवर्नेंस और डिजिटल साक्षरता के माध्यम से एक डिजिटल रूप से सशक्त समाज और ज्ञान आधारित अर्थव्यवस्था में बदलने के लिए 2015 में शुरू किया गया प्रमुख फ्लैगशिप अम्ब्रेला कार्यक्रम।
UPSC context
GS पेपर II (गवर्नेंस) और पेपर III (इन्फ्रास्ट्रक्चर)। ई-गवर्नेंस, डिजिटल डिवाइड को पाटने और सार्वजनिक सेवा वितरण को समझने के लिए महत्वपूर्ण।
भाषिणी
नेशनल लैंग्वेज ट्रांसलेशन मिशन (NLTM) के तहत एक AI-संचालित अनुवाद प्लेटफॉर्म, जिसे 22+ भारतीय भाषाओं में डिजिटल सेवाएं और सामग्री प्रदान करके भाषाई बाधाओं को दूर करने के लिए डिज़ाइन किया गया है।
UPSC context
GS पेपर II (सामाजिक न्याय/शासन) और पेपर III (S&T)। डिजिटल समावेशन, भाषाई विविधता और AI-संचालित सामाजिक सशक्तिकरण के प्रति जागरूकता का परीक्षण करता है।
प्रारंभिक ट्रैप
DPDP Act 2023 स्पष्ट रूप से भारतीय क्षेत्र के भीतर सभी व्यक्तिगत डेटा के भौतिक स्थानीयकरण (physical localization) को अनिवार्य करता है।
DPDP अधिनियम 2023 सीमा पार डेटा हस्तांतरण के लिए "नकारात्मक सूची" (negative list) दृष्टिकोण का उपयोग करता है, न कि सभी व्यक्तिगत डेटा को भारत में भौतिक रूप से स्थानीयकृत करने की व्यापक अनिवार्यता का।
संबंधित अवधारणाएँ
एज कंप्यूटिंग (Edge Computing) को पारंपरिक क्लाउड कंप्यूटिंग (Cloud Computing) से क्या अलग करता है?
- प्रसंस्करण स्थान: Edge डेटा को डिवाइस/स्रोत के भौगोलिक रूप से अधिक समीप प्रोसेस करता है, जबकि Cloud केंद्रीकृत और दूर स्थित सर्वर फार्म्स पर निर्भर करता है।
- विलंबता में कमी: केंद्रीय सर्वरों तक डेटा के राउंड-ट्रिप से बचकर, Edge रियल-टाइम और लो-लेटेंसी प्रोसेसिंग प्रदान करता है जो AI ऐप्स और ऑटोनॉमस सिस्टम के लिए महत्वपूर्ण है।
- बैंडविड्थ दक्षता: Edge क्लाउड पर केवल आवश्यक निष्कर्ष भेजने से पहले, विशाल डेटासेट को स्थानीय स्तर पर फ़िल्टर और प्रोसेस करके बैंडविड्थ चोकप्वॉइंट्स को कम करता है।
AI और जनरेटिव AI डेटा सेंटर विशिष्ट रूप से संसाधन-गहन क्यों होते हैं?
- शक्ति घनत्व: जनरेटिव AI सर्वर वर्कलोड प्रति रैक 80-150 KW की खपत करते हैं, जो पारंपरिक क्लाउड सर्वर के लिए आवश्यक 15-20 KW से कहीं अधिक है।
- कूलिंग फुटप्रिंट: हाई-डेंसिटी GPU क्लस्टर अत्यधिक गर्मी पैदा करते हैं, जिसके लिए निर्बाध 24x7 कूलिंग सिस्टम की आवश्यकता होती है, जो स्थानीय जल संसाधनों की भारी मात्रा का उपभोग करते हैं।
अंतर-विषय पैटर्न
AI डिजिटल पब्लिक इंफ्रास्ट्रक्चर (DPI) का विस्तार कर रहा है
भाषिनी (Bhashini) जैसी पहलें क्षेत्रीय भाषाओं में वॉयस-असिस्टेड इंटरफेस के माध्यम से मौजूदा DPIs (UPI, ONDC) के साथ एकीकृत होती हैं, जो गैर-अंग्रेजी भाषियों के लिए डिजिटल वित्तीय समावेशन का व्यापक रूप से विस्तार करती हैं।
AI कंप्यूट क्षमता बनाम नेट जीरो लक्ष्य
10,000+ GPU क्लस्टर्स के लिए 24x7 बिजली की अत्यधिक मांग, भारत के नेट जीरो 2070 लक्ष्यों के साथ सीधा टकराव पैदा करती है, जो 'ग्रीन डेटा सेंटर' (Green Data Centres) के लिए नीतिगत प्रोत्साहन को बढ़ावा दे रही है।

प्रारंभिक परीक्षा (Prelims) 2026 में Edge Computing, भाषिणी (Bhashini) के NLP मैंडेट और DPDP अधिनियम के डेटा ट्रांसफर नियमों को जोड़ने वाले एक बहु-कथनात्मक (multi-statement) प्रश्न की उम्मीद करें।
संबद्ध PYQ · 3
संबद्ध PYQ · 3
- 2020PrelimsGS1
With the present state of development, Artificial Intelligence can effectively do which of the following? 1. Bring down electricity consumption in industrial units 2. Create meaningful short stories and songs 3. Disease diagnosis 4. Text-to-Speech Conversion 5. Wireless transmission of electrical energy Select the correct answer using the code given below:
- 2023MainsGS3
What is the status of digitalization in the Indian economy? Examine the problems faced in this regard and suggest improvements.
- 2023MainsGS3
Introduce the concept of Artificial Intelligence (AI). How does Al help clinical diagnosis? Do you perceive any threat to privacy of the individual in the use of Al in healthcare?
