माइक्रोसॉफ्ट ने यूरोपीय भाषा एआई मॉडल में सुधार के लिए पहल शुरू की
स्रोत:द हिंदू ↗
क्यों मायने रखता है
अत्याधुनिक तकनीक, संस्कृति और भू-राजनीति के संगम को रेखांकित करता है। यह स्पष्ट करता है कि AI ट्रेनिंग डेटा में भाषाई प्रभुत्व किस प्रकार पूर्वाग्रह पैदा करता है, और कैसे वैश्विक टेक दिग्गज डेटा स्थानीयकरण (data localization) और रणनीतिक स्वायत्तता की अंतर्राष्ट्रीय माँगों के साथ तालमेल बिठा रहे हैं। यह GS3 (AI लोकलाइजेशन, ओपन-सोर्स टेक) और GS2 (डिजिटल संप्रभुता और वैश्विक तकनीकी विनियमन) के लिए अत्यधिक प्रासंगिक है।
सारांश
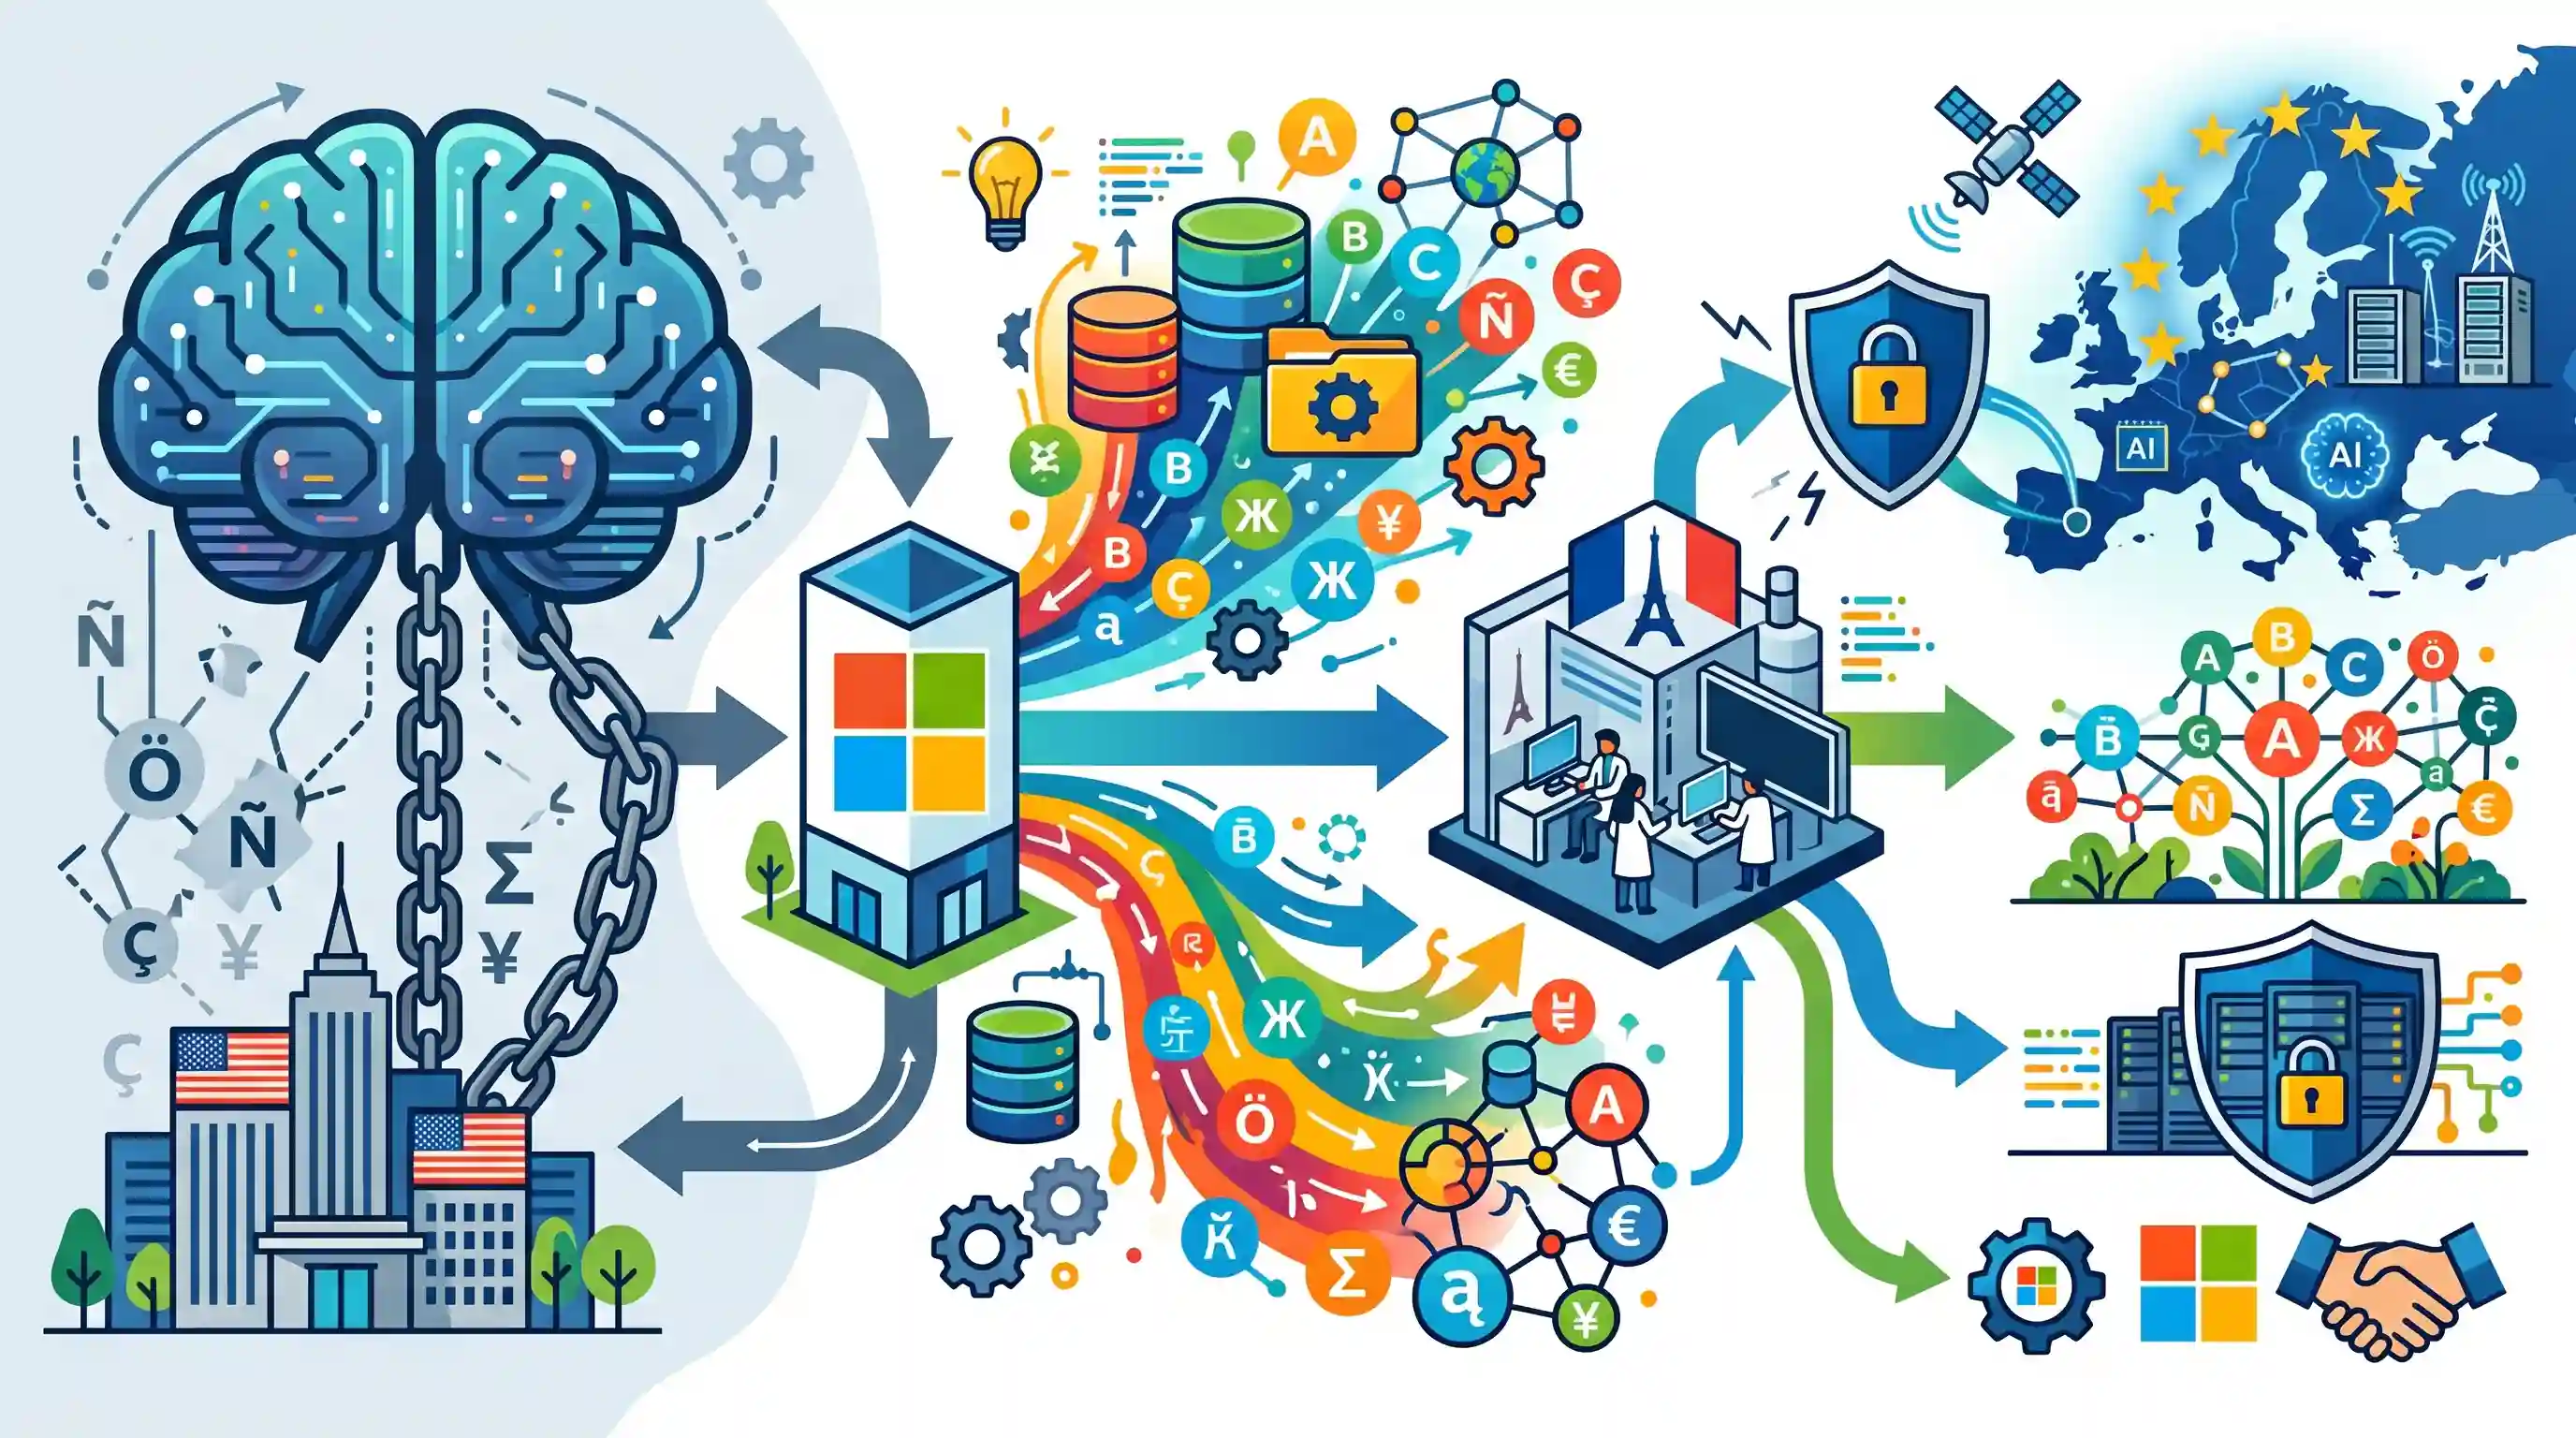
माइक्रोसॉफ्ट ने AI मॉडलों को प्रशिक्षित करने के लिए यूरोपीय भाषाओं के अनुकूल ओपन-सोर्स, बहुभाषी डेटासेट बनाने की एक प्रमुख पहल की घोषणा की है। इसका उद्देश्य AI क्षमताओं में वर्तमान अंग्रेजी वर्चस्व का मुकाबला करना है, जो अन्य भाषाओं में मॉडलों को कम प्रभावी बनाता है। फ्रांस में अनुसंधान इकाइयां स्थापित करके और ओपन-सोर्स डेटा के प्रति प्रतिबद्धता जताकर, माइक्रोसॉफ्ट यूरोप की "तकनीकी संप्रभुता" (technological sovereignty) की मांग को संबोधित करने, भाषाई विविधता को संरक्षित करने और अमेरिकी टेक फर्मों पर यूरोपीय निर्भरता से संबंधित भू-राजनीतिक चिंताओं के बीच अपनी बाजार स्थिति को सुरक्षित करने का प्रयास कर रहा है। माइक्रोसॉफ्ट ने अपने डेटा संप्रभुता उपायों पर भी प्रकाश डाला जो यूरोपीय प्रसंस्करण और भंडारण की अनुमति देते हैं।
मुख्य बिंदु
- माइक्रोसॉफ्ट ने AI मॉडल के प्रदर्शन को बेहतर बनाने के लिए कम से कम 10 यूरोपीय भाषाओं में उच्च गुणवत्ता वाला, ओपन-सोर्स डेटा तैयार करने की एक पहल शुरू की है।
- वर्तमान के प्रमुख AI मॉडल अंग्रेजी भाषा के प्रति पूर्वाग्रह (bias) से ग्रस्त हैं, जिसके परिणामस्वरूप अन्य भाषाओं में उनकी क्षमता कम हो जाती है और त्रुटियों (hallucinations) में वृद्धि होती है।
- इस पहल का उद्देश्य इस जनरेटेड डेटा को स्थानीय डेवलपर्स के लिए स्वतंत्र रूप से उपलब्ध कराकर यूरोपीय भाषाई और सांस्कृतिक विविधता को संरक्षित करने में सहायता करना है।
- यह कदम यूरोपीय संघ (European Union) के 'तकनीकी संप्रभुता' (technological sovereignty) के प्रयासों को संबोधित करता है और अमेरिकी टेक दिग्गजों पर निर्भरता को लेकर क्षेत्रीय चिंताओं को कम करने का लक्ष्य रखता है।
- माइक्रोसॉफ्ट की व्यापक रणनीति में स्थानीय डेटा संप्रभुता (data sovereignty) के उपाय शामिल हैं, जो यूरोपीय ग्राहकों को अपने डेटा को पूरी तरह से यूरोप के भीतर ही प्रोसेस और स्टोर करने की अनुमति देते हैं।
महत्वपूर्ण शब्द
तकनीकी संप्रभुता

किसी देश की महत्वपूर्ण प्रौद्योगिकियों (जैसे: AI, सेमीकंडक्टर) को स्वतंत्र रूप से विकसित करने और उन्हें नियंत्रित करने की क्षमता, जो रणनीतिक स्वायत्तता सुनिश्चित करती है और अमेरिका या चीन जैसी बाहरी शक्तियों पर एकतरफा निर्भरता को कम करती है।
UPSC context
GS पेपर 2 (अंतर्राष्ट्रीय संबंध) और GS 3 (S&T)। रणनीतिक स्वायत्तता और भू-राजनीतिक तकनीकी-निर्भरता की समझ का परीक्षण करता है।
डेटा संप्रभुता
वह सिद्धांत जिसके अनुसार डिजिटल डेटा उस क्षेत्राधिकार के कानूनों और शासन के अधीन होता है जहाँ इसे एकत्र, संसाधित (processed) या संग्रहीत किया जाता है, जो राष्ट्रीय सुरक्षा और गोपनीयता के लिए अत्यंत महत्वपूर्ण है।
UPSC context
GS पेपर 3 (विज्ञान एवं प्रौद्योगिकी/आंतरिक सुरक्षा)। डेटा संरक्षण ढांचे (DPDP अधिनियम) और साइबर सुरक्षा नीतियों के लिए प्रासंगिक।
TildeLM
लातवियाई कंपनी Tilde द्वारा विकसित एक ओपन-सोर्स, बहुभाषी फाउंडेशनल लार्ज लैंग्वेज मॉडल, जिसे 24+ यूरोपीय भाषाओं के लिए अनुकूलित किया गया है ताकि अंग्रेजी-केंद्रित AI का एक संप्रभु विकल्प प्रदान किया जा सके।
UPSC context
GS पेपर 3 (S&T)। संप्रभु AI विकास और स्वदेशी तकनीकी नवाचार के लिए एक केस स्टडी।
ओपन सोर्स AI
ऐसे AI सिस्टम जिनके सोर्स कोड और ट्रेनिंग डेटासेट सार्वजनिक रूप से सुलभ होते हैं, जो पारदर्शिता, सहयोगात्मक अनुसंधान और तकनीक के लोकतांत्रीकरण को सुगम बनाते हैं तथा प्रोप्रायटरी "ब्लैक-बॉक्स" मॉडलों के विपरीत कार्य करते हैं।
UPSC context
GS पेपर 3 (विज्ञान एवं प्रौद्योगिकी)। डिजिटल पब्लिक इंफ्रास्ट्रक्चर और समावेशी तकनीकी विकास की अवधारणाओं का परीक्षण करता है।
भाषाई विविधता (AI में)
डिजिटल डेटासेट में विभिन्न भाषाओं का न्यायसंगत प्रतिनिधित्व; AI में, यह सांस्कृतिक पूर्वाग्रह को रोकता है और गैर-अंग्रेजी भाषियों के लिए उच्च-प्रदर्शन वाली तकनीक सुनिश्चित करता है।
UPSC context
GS पेपर 1 (सामाजिक मुद्दे) और GS 3 (S&T)। डिजिटल डिवाइड और सांस्कृतिक संरक्षण से संबंधित।
लार्ज लैंग्वेज मॉडल्स (LLMs)
डीप लर्निंग एल्गोरिदम जो मानव-समान टेक्स्ट को समझने और उत्पन्न करने के लिए विशाल डेटासेट को प्रोसेस करते हैं; वर्तमान में ये ChatGPT और Mistral जैसे जेनेरेटिव AI टूल्स का आधार हैं।
UPSC context
GS Paper 3 (S&T)। आर्टिफिशियल इंटेलिजेंस और उभरती प्रौद्योगिकियों में बुनियादी अवधारणा।
प्रारंभिक ट्रैप
डेटा संप्रभुता यह अनिवार्य बनाती है कि सभी डिजिटल डेटा भौतिक रूप से किसी देश की भौगोलिक सीमाओं के भीतर ही संग्रहीत किया जाना चाहिए।
यह Data Localization का वर्णन करता है। Data Sovereignty का अर्थ है कि डेटा उस देश के कानूनों के अधीन है जिसने इसे एकत्र किया है, जो कानूनी ढांचे के आधार पर cross-border flows की अनुमति दे सकता है।
संबंधित अवधारणाएँ
डेटा संप्रभुता (Data Sovereignty) और डेटा स्थानीयकरण (Data Localization) के बीच क्या अंतर है?
- डेटा स्थानीयकरण: किसी देश की क्षेत्रीय सीमाओं के भीतर ही नागरिकों के डेटा के भौतिक भंडारण और प्रसंस्करण को अनिवार्य बनाना।
- डेटा संप्रभुता: वह सिद्धांत कि डेटा उस राष्ट्र के कानूनों और शासन संरचनाओं के अधीन है जहाँ इसे एकत्र किया गया है, चाहे उसका भौतिक भंडारण स्थान कहीं भी हो।
भारत स्वदेशी रूप से भाषाई AI पक्षपात से कैसे निपट रहा है?
- प्रोजेक्ट भाषिणी: डिजिटल सेवा वितरण में भाषाई बाधाओं को दूर करने के लिए भारत का राष्ट्रीय भाषा अनुवाद मिशन (National Language Translation Mission) ओपन-सोर्स AI डेटासेट तैयार कर रहा है।
- वॉयस-आधारित ई-गवर्नेंस: स्थानीयकृत AI मॉडल (जैसे जुगलबंदी) का उपयोग करना ताकि ग्रामीण नागरिक अपनी स्थानीय भाषाओं के माध्यम से सरकारी योजनाओं के साथ जुड़ सकें।
अंतर-विषय पैटर्न
डिजिटल पब्लिक इंफ्रास्ट्रक्चर के माध्यम से तकनीकी संप्रभुता
जहाँ यूरोप ओपन-सोर्स AI डेटासेट के लिए विदेशी टेक दिग्गजों पर निर्भर है, वहीं भारत स्वतंत्र तकनीकी संप्रभुता सुनिश्चित करने के लिए स्वदेशी डिजिटल पब्लिक इंफ्रास्ट्रक्चर (जैसे भाषिणी) का निर्माण कर रहा है।
एल्गोरिथम पूर्वाग्रह और सांस्कृतिक आधिपत्य
विशेष रूप से अंग्रेजी डेटा पर प्रशिक्षित AI भाषाई विविधता के लिए खतरा पैदा करता है। UPSC अक्सर ऐसी उभरती प्रौद्योगिकियों को वैश्वीकरण और सांस्कृतिक समरूपीकरण के समाजशास्त्रीय प्रभावों के साथ जोड़ता है।

भारत (DPI/Bhashini) बनाम EU (AI Act) किस प्रकार AI भाषाई पूर्वाग्रह (linguistic bias) और डेटा संप्रभुता (data sovereignty) का समाधान करते हैं, इस पर एक तुलनात्मक Mains प्रश्न की अपेक्षा करें।
संबद्ध PYQ · 5
संबद्ध PYQ · 5
- 2023MainsGS3
Introduce the concept of Artificial Intelligence (AI). How does Al help clinical diagnosis? Do you perceive any threat to privacy of the individual in the use of Al in healthcare?
- 2015MainsGS3
India's Traditional Knowledge Digital Library (TKDL), which has a database containing formatted information on more than 2 million medicinal formulations is proving a powerful weapon in the country's fight against erroneous patents. Discuss the pros and cons of making this database publicly available under open-source licensing.
- 2022PrelimsGS1
Consider the following : 1. Aarogya Setu 2. CoWIN 3. DigiLocker 4. DIKSHA Which of the above are built on top of open-source digital platforms?
- 2022MainsGS1
Elucidate the relationship between globalization and new technology in a world of scarce resources, with special reference to India.
- 2020MainsGS1
Is diversity and pluralism in India under threat due to globalisation ? Justify your answer.
