सामग्री निर्माताओं के डेटा उपयोग के लिए भारतीय AI रॉयल्टी प्रस्ताव
स्रोत:द हिंदू ↗
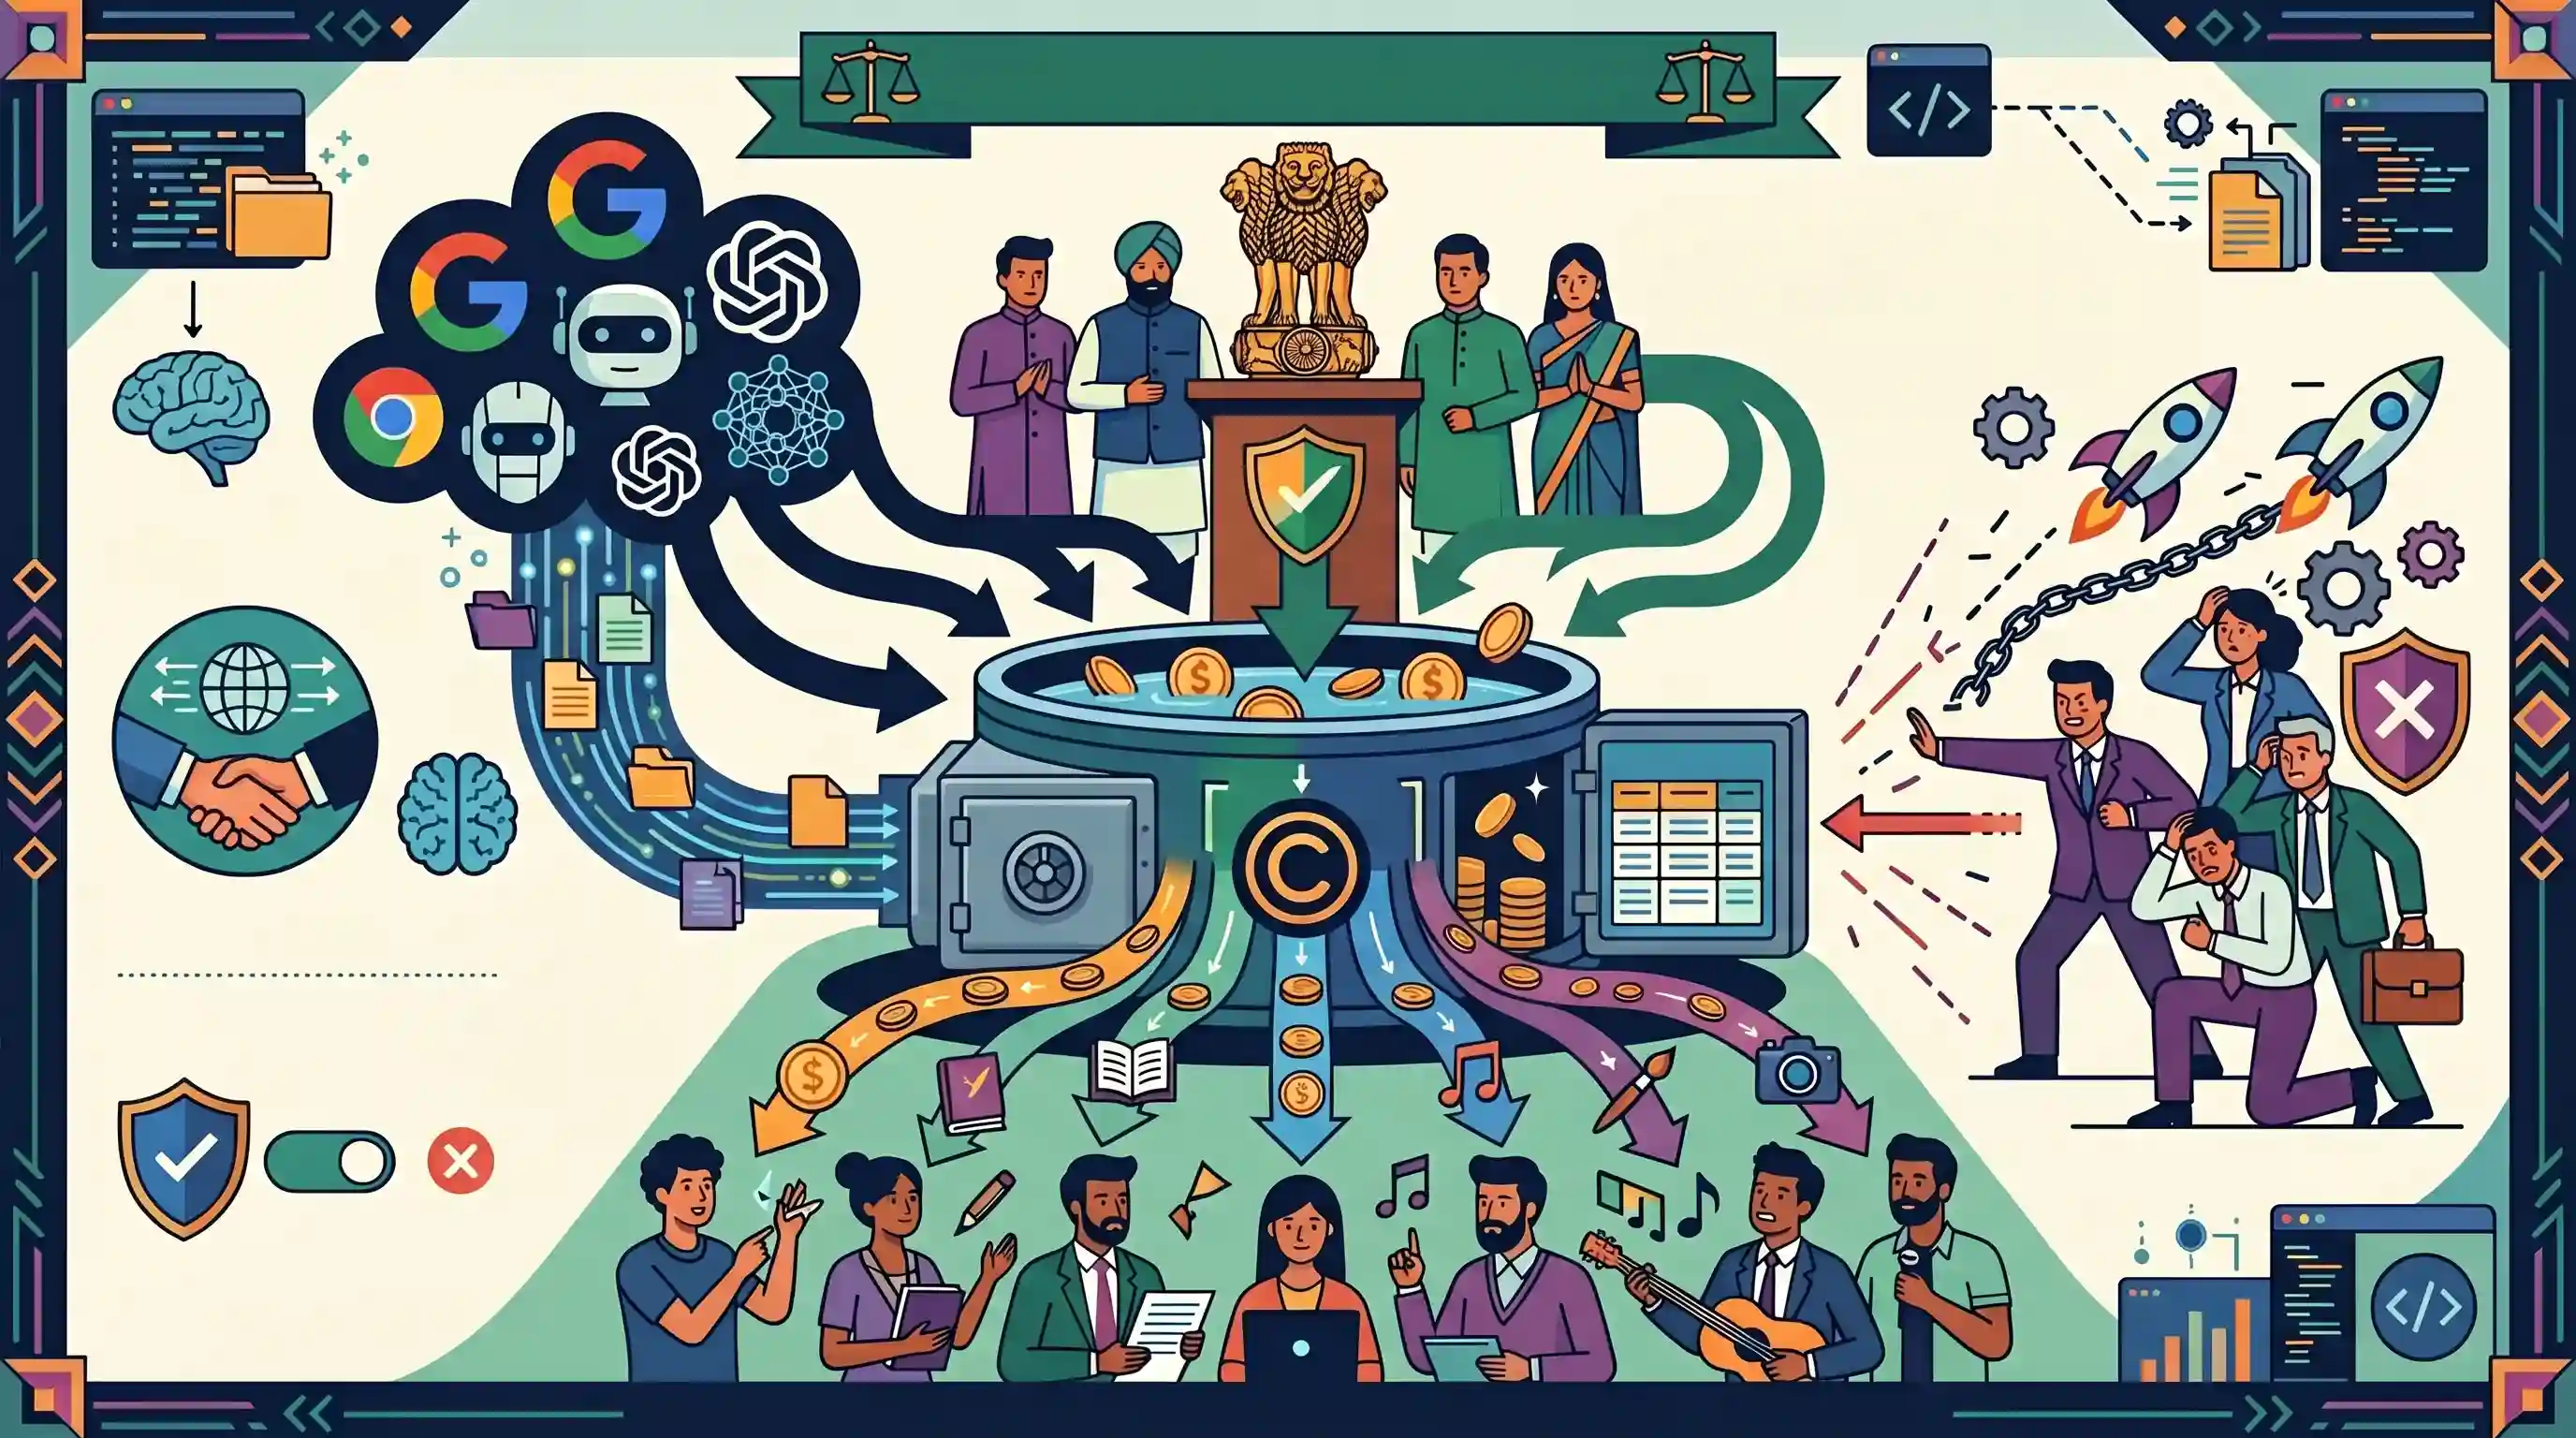
क्यों मायने रखता है
AI नवाचार और बौद्धिक संपदा अधिकारों का संगम एक महत्वपूर्ण वैश्विक बहस है। यह भारतीय प्रस्ताव एक विशिष्ट गवर्नेंस मॉडल (केंद्रीकृत रॉयल्टी) का प्रतिनिधित्व करता है जो US और EU के दृष्टिकोणों के विपरीत है, जिससे यह GS3 (विज्ञान एवं तकनीक / IPR) और GS2 (सरकारी नीतियां) में प्रौद्योगिकी विनियमन, फेयर यूज और रचनाकारों के अधिकारों से संबंधित प्रश्नों के लिए अत्यधिक प्रासंगिक हो जाता है।
सारांश
भारत सरकार के एक पैनल ने एक नए नियामक ढांचे का प्रस्ताव दिया है, जिसमें गूगल और OpenAI जैसी आर्टिफिशियल इंटेलिजेंस कंपनियों को AI मॉडल प्रशिक्षित करने के लिए कंटेंट क्रिएटर्स के डेटा का उपयोग करने के बदले उन्हें रॉयल्टी भुगतान करना होगा। यह पैनल एक कॉपीराइट निकाय द्वारा प्रबंधित एक केंद्रीकृत रॉयल्टी पूल की वकालत करता है, जो अमेरिका के 'फेयर यूज' दृष्टिकोण के बिल्कुल विपरीत है और इसने यूरोपीय संघ के 'ऑप्ट-आउट' मॉडल को रचनाकारों के लिए अप्रभावी बताते हुए खारिज कर दिया है। जेनरेटिव AI के युग में बौद्धिक संपदा अधिकारों की रक्षा के उद्देश्य से लाए गए इस प्रस्ताव को नैसकॉम (Nasscom) और मोशन पिक्चर एसोसिएशन जैसे तकनीकी एवं मीडिया उद्योग निकायों के कड़े विरोध का सामना करना पड़ रहा है, जिनका तर्क है कि यह नवाचार पर टैक्स लगाने के समान है।
मुख्य बिंदु
- भारत सरकार के एक पैनल ने प्रस्ताव दिया है कि AI कंपनियां अपने मॉडल को प्रशिक्षित करने के लिए कंटेंट क्रिएटर्स के कार्यों का उपयोग करने के बदले उन्हें राजस्व का एक हिस्सा प्रदान करें।
- प्रस्ताव में रॉयल्टी एकत्र करने और वितरित करने के लिए एक केंद्रीकृत निकाय का सुझाव दिया गया है, जो EU में देखे गए 'ऑप्ट-आउट' मॉडल से बचता है जिसे पैनल अप्रभावी मानता है।
- यह US के रुख से अलग है, जहाँ AI दिग्गज दावा करते हैं कि सार्वजनिक रूप से उपलब्ध डेटा पर ट्रेनिंग 'fair use' है।
- Nasscom और मोशन पिक्चर एसोसिएशन जैसे उद्योग निकाय इस कदम का विरोध कर रहे हैं और इसे 'नवाचार पर टैक्स' बता रहे हैं।
महत्वपूर्ण शब्द
कॉपीराइट अधिनियम, 1957

भारत का प्रमुख विधान (2012 में संशोधित) जो साहित्यिक और कलात्मक कार्यों की रक्षा करता है। यह रचनाकारों को अनन्य अधिकार (exclusive rights) प्रदान करता है और अनुसंधान एवं शिक्षा के लिए 'fair dealing' (फेयर डीलिंग) अपवादों को रेखांकित करता है।
UPSC context
GS Paper 3: IPR। जेनरेटिव AI जैसी विघटनकारी प्रौद्योगिकियों के प्रति पारंपरिक कानून किस प्रकार अनुकूलित होते हैं, इसके विश्लेषण के लिए महत्वपूर्ण।
उचित व्यवहार का सिद्धांत
भारत के कॉपीराइट अधिनियम की धारा 52 के तहत एक कानूनी सिद्धांत, जो शोध, आलोचना या समाचार रिपोर्टिंग जैसे विशिष्ट उद्देश्यों के लिए बिना अनुमति के कॉपीराइट वाले कार्यों के सीमित उपयोग की अनुमति देता है।
UPSC context
GS पेपर 3: IPR। भारतीय कानून में वाणिज्यिक AI प्रशिक्षण और वैधानिक अपवादों के बीच की कानूनी सीमा का परीक्षण करता है।
AI ट्रेनिंग के लिए कॉपीराइट रॉयल्टी कलेक्टिव (CRCAT)
भारत में प्रस्तावित एक केंद्रीय एजेंसी, जिसे उन रचनाकारों को मुआवजा देने के लिए AI कंपनियों से अनिवार्य रॉयल्टी एकत्र करने का कार्य सौंपा गया है, जिनके डेटा का उपयोग मॉडल प्रशिक्षण (model training) के लिए किया जाता है।
UPSC context
GS पेपर 3: विनियमन। यह अमेरिका या EU मॉडलों की तुलना में भारत के अद्वितीय 'statutory licensing' दृष्टिकोण का प्रतिनिधित्व करता है।
नैसकॉम
भारत के IT-BPM उद्योग के लिए सर्वोच्च व्यापारिक संस्था। यह तकनीक-अनुकूल नीतियों की वकालत करती है और हाल ही में इसने अनिवार्य AI रॉयल्टी का विरोध करते हुए इसे 'नवाचार पर कर' (tax on innovation) करार दिया है।
UPSC context
GS पेपर 3: अर्थव्यवस्था/IT। डिजिटल अर्थव्यवस्था और विनियामक परामर्शों में एक प्रमुख हितधारक।
ANI (एशियन न्यूज इंटरनेशनल)
प्रमुख भारतीय समाचार एजेंसी जिसने OpenAI के खिलाफ एक ऐतिहासिक मुकदमा दायर किया है, जिसमें ChatGPT को प्रशिक्षित करने के लिए अपनी समाचार सामग्री के अनाधिकृत उपयोग का आरोप लगाया गया है।
UPSC context
GS पेपर 3: विज्ञान एवं प्रौद्योगिकी। AI और कॉपीराइट उल्लंघन के लिए भारत के पहले प्रमुख कानूनी मिसाल में शामिल।
ओपनएआई
अमेरिका स्थित शोध संस्थान और ChatGPT का निर्माता। इसका तर्क है कि सार्वजनिक डेटा पर AI को प्रशिक्षित करना 'फेयर यूज' (fair use) के दायरे में आता है और यह भारतीय न्यायालयों के क्षेत्राधिकार पर सवाल उठाता है।
UPSC context
GS पेपर 3: प्रौद्योगिकी। एक प्रमुख वैश्विक इकाई जिसके संचालन राष्ट्रीय डेटा और IPR ढांचे को चुनौती देते हैं।
जेनरेटिव AI
AI का एक उप-समूह जो विशाल डेटासेट में पैटर्न का विश्लेषण करके नई सामग्री (टेक्स्ट, इमेज, कोड) तैयार करता है, जिससे डेटा स्क्रैपिंग और रचनाकारों के अधिकारों को लेकर वैश्विक बहस छिड़ गई है।
UPSC context
GS Paper 3: विज्ञान एवं प्रौद्योगिकी। एक प्रमुख उभरता हुआ तकनीकी विषय जिसके लिए संभावनाओं और विनियामक जोखिमों, दोनों की समझ आवश्यक है।
प्रारंभिक ट्रैप
भारत का प्रस्तावित AI ढांचा कंटेंट क्रिएटर्स की सुरक्षा के लिए यूरोपीय संघ के 'ऑप्ट-आउट' मॉडल को अपनाता है।
DPIIT पैनल ने स्पष्ट रूप से EU के 'ऑप्ट-आउट' मॉडल को यह तर्क देते हुए खारिज कर दिया कि यह रचनाकारों पर अनुचित बोझ डालता है, और इसके बजाय एक अनिवार्य केंद्रीय रॉयल्टी पूल (central royalty pool) का प्रस्ताव दिया।
संबंधित अवधारणाएँ
भारतीय कॉपीराइट अधिनियम, 1957 के तहत 'Fair Dealing' क्या है?
- परिभाषा: कॉपीराइट सामग्री के बिना अनुमति के सीमित उपयोग की अनुमति देने वाला एक अपवाद। यह अमेरिका के व्यापक 'Fair Use' सिद्धांत की तुलना में अधिक प्रतिबंधात्मक है।
- अनुमत उपयोग: इसमें निजी/व्यक्तिगत शोध, आलोचना, समीक्षा और समसामयिक घटनाओं की रिपोर्टिंग शामिल है (अधिनियम की धारा 52)।
- वाणिज्यिक AI अंतराल: व्यावसायिक AI प्रशिक्षण के लिए मास डेटा स्क्रैपिंग वर्तमान में इन पारंपरिक अपवादों के दायरे से बाहर है, जिससे नए नियामक ढाँचों की आवश्यकता उत्पन्न होती है।
जनरेटिव AI मॉडल टेक्स्ट एंड डेटा माइनिंग (TDM) का उपयोग किस प्रकार करते हैं?
- डेटा स्क्रैपिंग: AI डेवलपर्स टेक्स्ट, इमेज और कोड सहित सार्वजनिक रूप से उपलब्ध इंटरनेट डेटा की भारी मात्रा को स्क्रैप करने के लिए ऑटोमेटेड बॉट्स का उपयोग करते हैं।
- मॉडल ट्रेनिंग: TDM इस असंरचित डेटा को प्रोसेस करता है, और मॉडल को पैटर्न, सिंटैक्स और सीमेंटिक्स पर प्रशिक्षित करने के लिए इसे न्यूरल नेटवर्क्स में फीड करता है।
- IPR विवाद: चूंकि उपयोग किए गए डेटासेट में अनिवार्य रूप से कॉपीराइट सामग्री होती है, इसलिए व्युत्पन्न सामग्री (derivative content) तैयार करना वैश्विक स्तर पर कॉपीराइट उल्लंघन और मुआवजे की गंभीर चिंताओं को जन्म देता है।
अंतर-विषय पैटर्न
डेटा संप्रभुता से एआई डेटा रॉयल्टी तक
जिस तरह DPDP Act डेटा स्थानीयकरण और गोपनीयता पर केंद्रित था, नई IPR व्यवस्था विदेशी Big Tech एल्गोरिदम द्वारा शोषण के विरुद्ध भारतीय बौद्धिक पूंजी के मुद्रीकरण पर ध्यान केंद्रित करती है।
वैश्विक तकनीकी विनियमन के विभिन्न मॉडल
भारत केंद्रीय राज्य-समर्थित संस्थाओं (जैसे प्रस्तावित CRCAT) पर निर्भर है, EU कठोर नागरिक अधिकारों (opt-out) पर ध्यान केंद्रित करता है, और अमेरिका नवाचार को बढ़ावा देने के लिए कॉर्पोरेट 'fair use' का पक्ष लेता है।

2026 की GS3 Mains में भारत के प्रस्तावित AI रॉयल्टी ढांचे की तुलना अमेरिका के 'fair use' और EU के 'opt-out' दृष्टिकोणों से करने वाले एक प्रश्न की अपेक्षा करें।
संबद्ध PYQ · 5
संबद्ध PYQ · 5
- 2023MainsGS3
Introduce the concept of Artificial Intelligence (AI). How does Al help clinical diagnosis? Do you perceive any threat to privacy of the individual in the use of Al in healthcare?
- 2014MainsGS3
In a globalized world, Intellectual Property Rights assume significance and are a source of litigation. Broadly distinguish between the terms-Copyrights, Patents and Trade Secrets.
- 2020PrelimsGS1
With the present state of development, Artificial Intelligence can effectively do which of the following? 1. Bring down electricity consumption in industrial units 2. Create meaningful short stories and songs 3. Disease diagnosis 4. Text-to-Speech Conversion 5. Wireless transmission of electrical energy Select the correct answer using the code given below:
- 2002PrelimsGS1
Consider the following statements: 1. The World Intellectual Property Organisation (WIPO) is a specialised agency of United Nations System of Organisations 2. WIPO has its headquarters at Rome 3. The Trade Related Aspects of Intellectual Property Rights (TRIPS) Agreement is binding on all WTO members 4. Least developed country members of WTO are not required to apply the provisions of TRIPS Agreements for a period of 20 years from the general date of application of the Agreement Which of these statements are correct?
- 2023PrelimsGS1
Consider the investments in the following assets: 1. Brand recognition 2. Inventory 3. Intellectual property 4. Mailing list of clients How many of the above are considered intangible investments?
