गूगल ने सतत सीखने के लिए प्रायोगिक एआई मॉडल होप पेश किया
स्रोत:इंडियन एक्सप्रेस ↗
क्यों मायने रखता है
आर्टिफिशियल इंटेलिजेंस (Artificial Intelligence) पर प्रश्न UPSC GS3 और निबंध (Essay) के प्रश्नपत्रों में बार-बार पूछे जाते हैं। 'Catastrophic Forgetting', 'Continual Learning' और 'Artificial General Intelligence (AGI)' जैसी शब्दावलियों का वैचारिक ज्ञान अभ्यर्थियों को वर्तमान AI की सीमाओं, इसके भविष्य के प्रक्षेपवक्र (trajectory) और मानव बुद्धिमत्ता की नकल करने के लिए आवश्यक तकनीकी हस्तक्षेपों पर सूक्ष्म उत्तर लिखने में मदद करता है।
सारांश
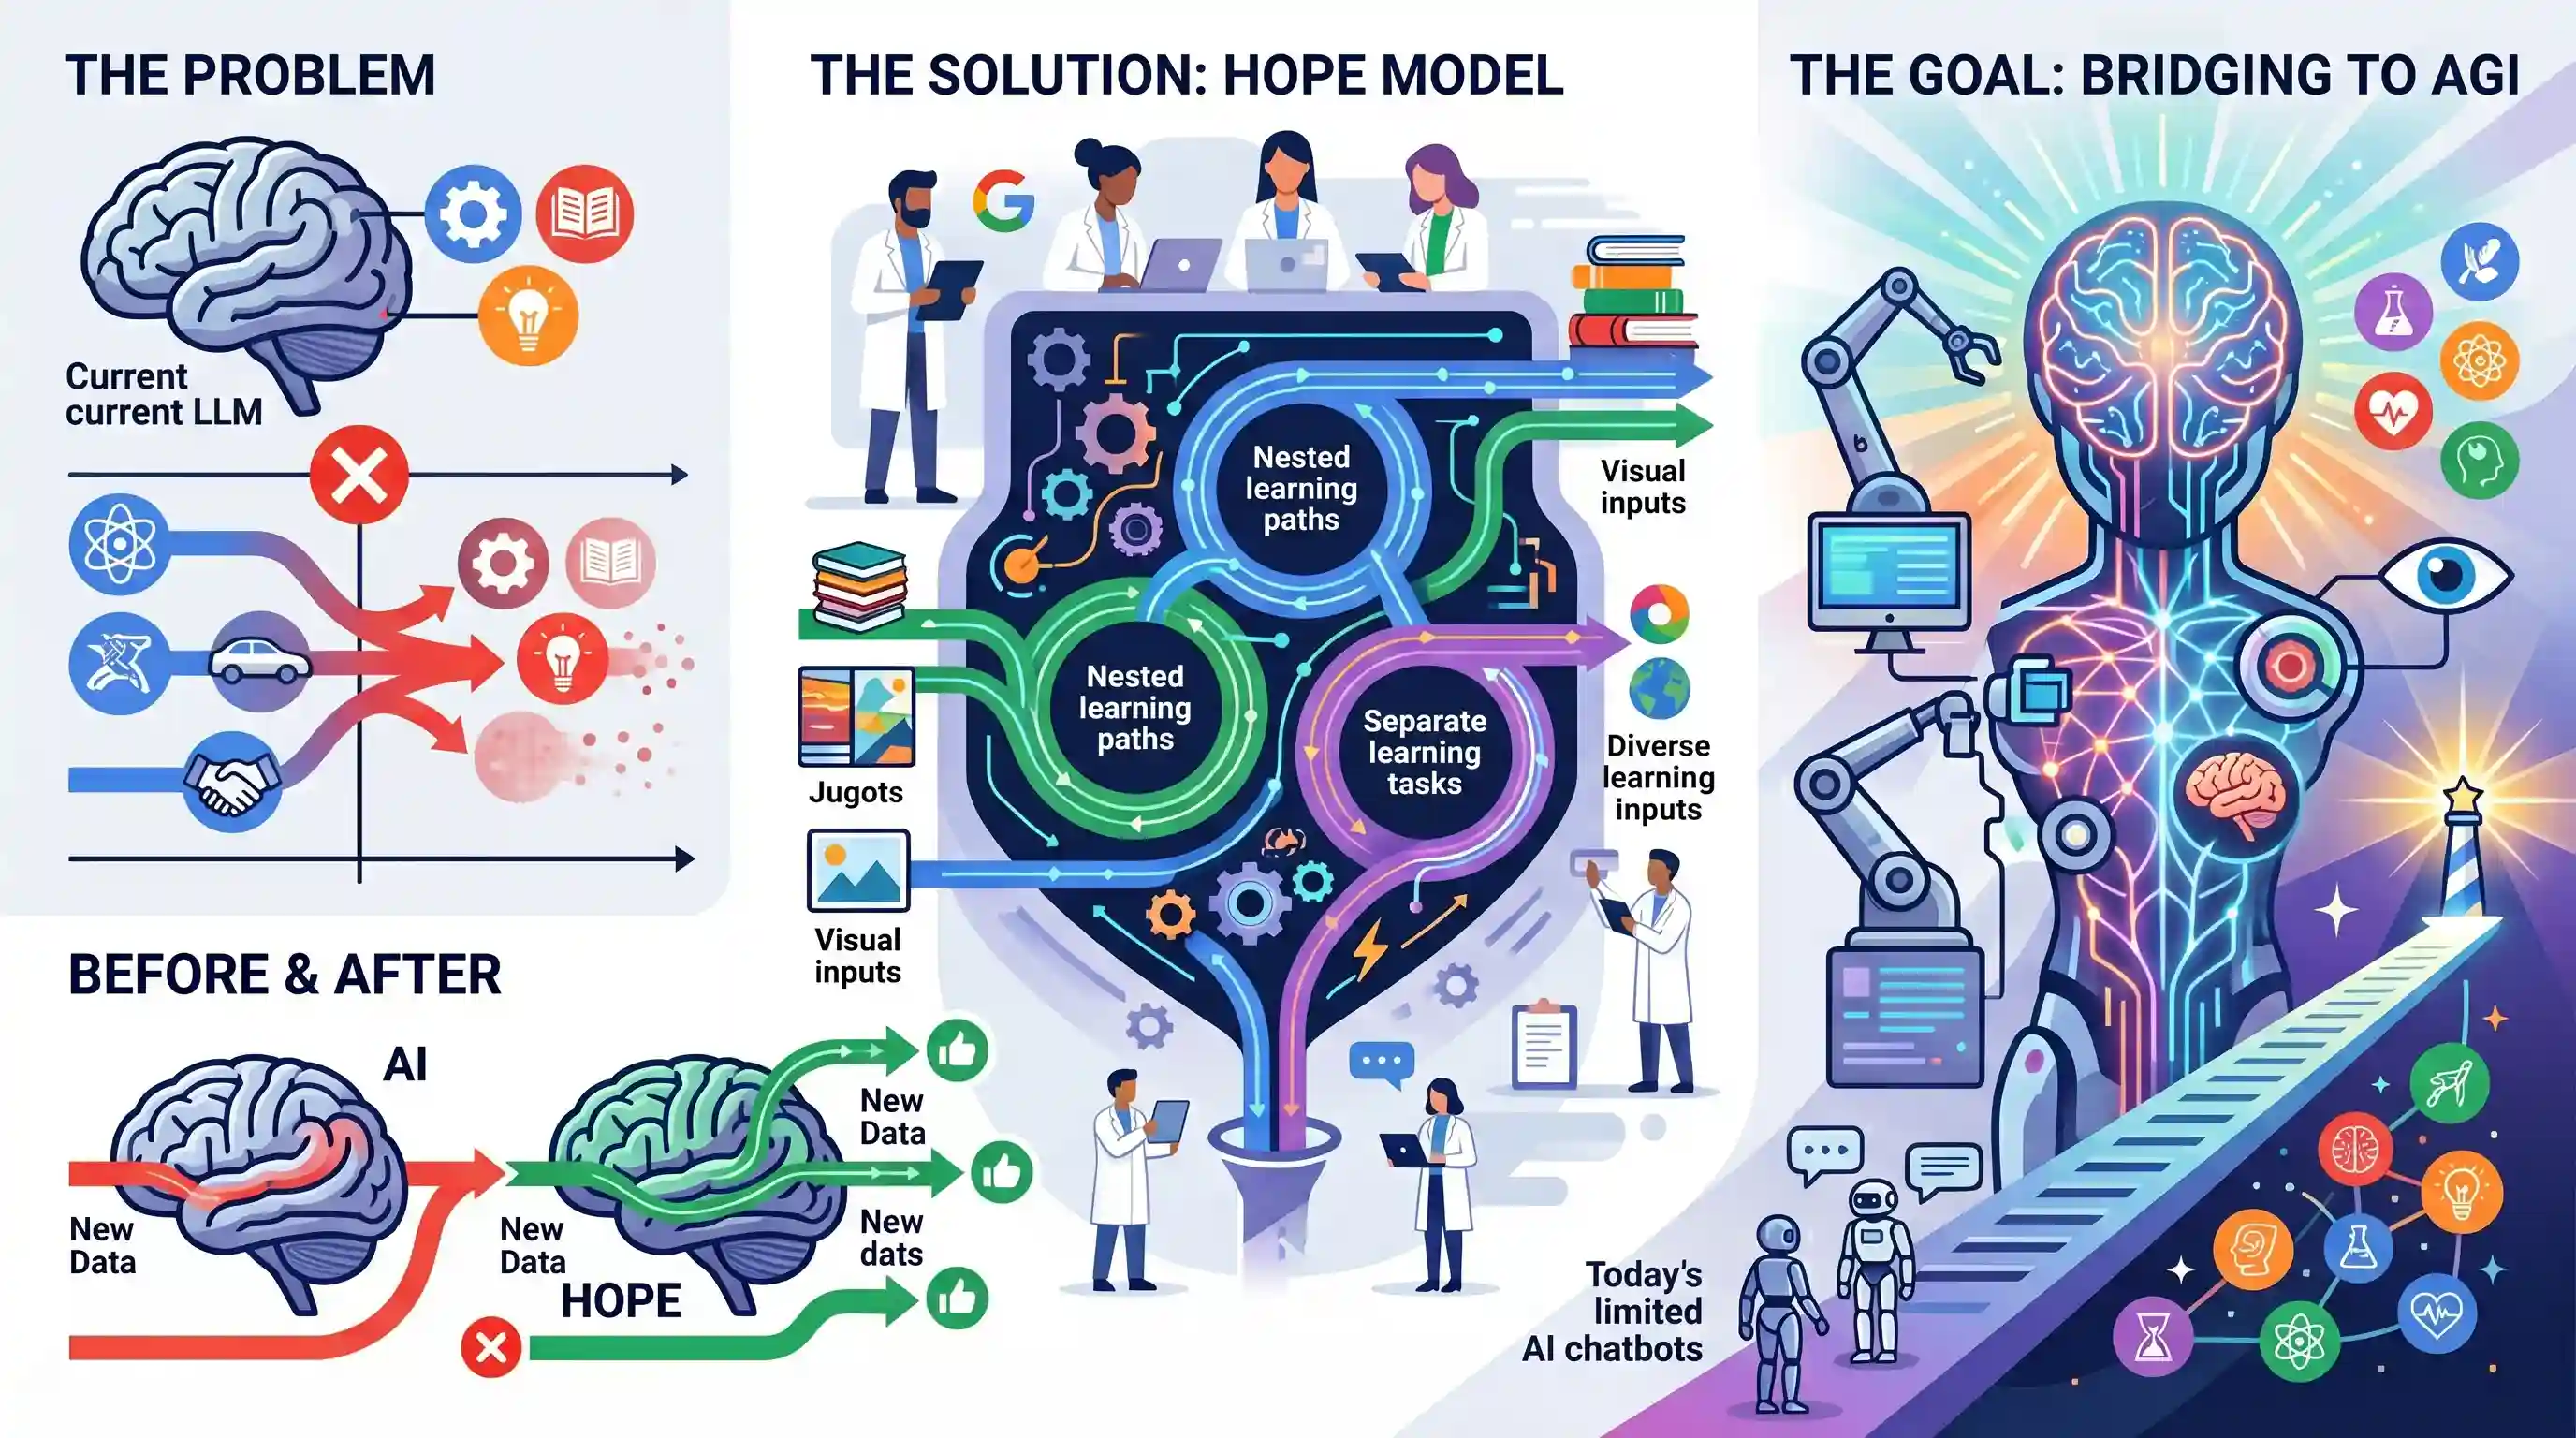
Google शोधकर्ताओं ने 'HOPE' नामक एक नया प्रयोगात्मक machine learning मॉडल विकसित किया है, जो आधुनिक AI की सबसे बड़ी बाधाओं में से एक: 'catastrophic forgetting' को हल करने की दिशा में एक महत्वपूर्ण कदम है। वर्तमान Large Language Models (LLMs) मौजूदा ज्ञान को ओवरराइट किए बिना नई जानकारी सीखने में कठिनाई का सामना करते हैं। इससे निपटने के लिए, HOPE 'nested learning' पर आधारित एक self-modifying आर्किटेक्चर का उपयोग करता है, जो एक साथ कई परस्पर जुड़ी लर्निंग समस्याओं को अनुकूलित (optimize) करता है। मानव मस्तिष्क की निरंतर सीखने की क्षमताओं (continual learning capabilities) का अनुकरण करके, Google का लक्ष्य आज के AI चैटबॉट्स और Artificial General Intelligence (AGI) के बीच के अंतर को कम करना है।
मुख्य बिंदु
- गूगल ने 'HOPE' नामक एक प्रायोगिक AI मॉडल पेश किया है, जिसका उद्देश्य आर्टिफिशियल इंटेलिजेंस में निरंतर सीखने की क्षमताओं (continual learning capabilities) को आगे बढ़ाना है।
- यह मॉडल 'nested learning' नामक एक नई अवधारणा का उपयोग करता है, जो एक AI मॉडल को एक साथ संसाधित (processed) की जाने वाली परस्पर जुड़ी, बहु-स्तरीय अनुकूलन समस्याओं (multi-level optimization problems) के एक तंत्र के रूप में देखता है।
- यह आर्किटेक्चर 'कैटैस्ट्रोफिक फॉरगेटिंग' (CF) का समाधान करता है, जो वर्तमान लार्ज लैंग्वेज मॉडल्स (LLMs) की एक बड़ी खामी है जिसमें नई जानकारी सीखते समय वे मौजूदा ज्ञान खो देते हैं।
- निरंतर सीखने (Continual learning) को विशेषज्ञों द्वारा आर्टिफिशियल जनरल इंटेलिजेंस (AGI) या मानव-जैसी बुद्धिमत्ता की दिशा में एक महत्वपूर्ण लुप्त कड़ी के रूप में व्यापक रूप से माना जाता है।
- 'HOPE' मॉडल एक 'प्रूफ-ऑफ-कॉन्सेप्ट' के रूप में कार्य करता है, जो विविध तार्किक कार्यों (reasoning tasks) में आधुनिक LLMs की तुलना में उच्च सटीकता और कम पेरप्लेक्सिटी (perplexity) प्रदर्शित करता है।
महत्वपूर्ण शब्द
आर्टिफिशियल जनरल इंटेलिजेंस (AGI)

AI का एक काल्पनिक स्वरूप जो किसी भी ऐसे कार्य को समझने, सीखने और बुद्धिमत्ता लागू करने में सक्षम है जिसे एक मानव कर सकता है, तथा जो विशिष्ट कार्य-प्रशिक्षण (task-training) से परे क्रॉस-डोमेन रीजनिंग और स्थायी स्मृति (persistent memory) प्रदर्शित करता है।
UPSC context
GS पेपर III (S&T); AI के भविष्य के विकास, मानव-मशीन समानता और समाज एवं सुरक्षा पर संभावित विघटनकारी प्रभावों की समझ का परीक्षण करता है।
सतत अधिगम
AI की एक ऐसी क्षमता जो महंगे और समय लेने वाले पूर्ण पुनः प्रशिक्षण (full retraining) की आवश्यकता के बिना, पहले से सीखी गई जानकारी को सुरक्षित रखते हुए नए डेटा के निरंतर प्रवाह से क्रमिक रूप से ज्ञान प्राप्त करने में सक्षम बनाती है।
UPSC context
GS पेपर III (S&T); स्वास्थ्य सेवा, अंतरिक्ष अन्वेषण और रक्षा में एडेप्टिव सिस्टम्स (adaptive systems) के लिए प्रासंगिक, जहाँ निरंतर रियल-टाइम लर्निंग (persistent real-time learning) अत्यंत महत्वपूर्ण है।
विनाशकारी विस्मरण (Catastrophic Forgetting)
न्यूरल नेटवर्क में एक बड़ी विफलता जिसमें नई जानकारी वेट पैरामीटर्स (weight parameters) को इस तरह अपडेट करती है कि वह मौजूदा ज्ञान को ओवरराइट कर उसे मिटा देती है, जिससे मॉडल अपने पिछले कौशल खो देता है।
UPSC context
GS पेपर III (S&T); डीप लर्निंग की बुनियादी बाधाओं और वर्तमान स्टैटिक मशीन लर्निंग मॉडलों की सीमाओं के ज्ञान का परीक्षण करता है।
नेस्टेड लर्निंग
एक उभरता हुआ AI आर्किटेक्चर जो एक एकल मॉडल को परस्पर जुड़े, बहु-स्तरीय optimization sub-problems के पदानुक्रम (hierarchy) के रूप में देखता है, जो जैविक मस्तिष्क जैसी रिटेंशन (retention) क्षमता की नकल करने के लिए विभिन्न गतियों पर अपडेट होते हैं।
UPSC context
GS पेपर III (S&T); कंप्यूटेशनल आर्किटेक्चर में उन प्रयोगात्मक सफलताओं पर केंद्रित है जो नैरो AI और जनरल इंटेलिजेंस के बीच के अंतर को पाटती हैं।
लार्ज लैंग्वेज मॉडल्स (LLMs)
उन्नत AI सिस्टम जिन्हें विशाल टेक्स्ट डेटासेट्स पर मानवीय भाषा को प्रोसेस और जेनरेट करने के लिए प्रशिक्षित किया गया है, जो ChatGPT और Google Gemini जैसे आधुनिक चैटबॉट्स का मुख्य आधार हैं।
UPSC context
GS पेपर III (S&T); डिजिटल क्रांति, ऑटोमेशन और नेचुरल लैंग्वेज प्रोसेसिंग (natural language processing) अनुप्रयोगों से संबंधित विषयों के लिए आधारभूत ज्ञान।
प्रारंभिक ट्रैप
AI में कैटास्ट्रोफिक फॉरगेटिंग (Catastrophic forgetting) का तात्पर्य सीमित क्लाउड स्टोरेज या सर्वर मेमोरी की बाधाओं के कारण होने वाली डेटा हानि से है।
यह हार्डवेयर स्टोरेज की समस्या नहीं है। यह न्यूरल नेटवर्क में एक बुनियादी एल्गोरिद्मिक खामी है जहाँ नए डेटा पैटर्न को सीखना स्वचालित रूप से पहले से सीखे गए पैरामीटर्स (parameters) को ओवरराइट कर देता है।
संबंधित अवधारणाएँ
आर्टिफिशियल इंटेलिजेंस के विकास के तीन चरण क्या हैं?
- आर्टिफिशियल नैरो इंटेलिजेंस: वर्तमान AI सिस्टम जिन्हें विशिष्ट, प्री-प्रोग्राम्ड कार्यों (जैसे, Siri, फेशियल रिकग्निशन, भाषा अनुवाद) को करने के लिए डिज़ाइन किया गया है।
- आर्टिफिशियल जनरल इंटेलिजेंस: एक सैद्धांतिक चरण जहाँ मशीनों में किसी भी बौद्धिक कार्य को सीखने और निष्पादित करने के लिए सामान्यीकृत, मानव-समान संज्ञानात्मक लचीलापन (cognitive flexibility) होता है।
- कृत्रिम सुपरइंटेलिजेंस: एक काल्पनिक भविष्य का चरण जहाँ AI सभी विषयों और क्षेत्रों में मानव बुद्धिमत्ता और क्षमता से आगे निकल जाता है।
मशीन लर्निंग (Machine Learning), डीप लर्निंग (Deep Learning) और LLMs वैचारिक रूप से एक-दूसरे से कैसे भिन्न हैं?
- मशीन लर्निंग (ML): एल्गोरिदम जो संरचित डेटा का विश्लेषण करते हैं, उससे सीखते हैं, और प्रत्येक परिदृश्य के लिए स्पष्ट प्रोग्रामिंग के बिना सूचित निर्णय लेते हैं।
- डीप लर्निंग: ML का एक उपसमूह जो मल्टी-लेयर्ड आर्टिफिशियल न्यूरल नेटवर्क का उपयोग करता है, और जिसे मानव मस्तिष्क के सीखने की प्रक्रिया की नकल करने के लिए विशाल अनस्ट्रक्चर्ड डेटा की आवश्यकता होती है।
- लार्ज लैंग्वेज मॉडल्स: मानव भाषा को समझने, सारांशित करने और उत्पन्न करने के लिए विशाल टेक्स्ट डेटासेट पर प्रशिक्षित डीप लर्निंग मॉडल।
अंतर-विषय पैटर्न
AI की कंप्यूटिंग और कार्बन फुटप्रिंट
कॉन्टिनुअल लर्निंग मॉडल LLMs को शून्य से पुनः प्रशिक्षित करने की आवश्यकता को कम करते हैं, जिससे आधुनिक AI डेटा केंद्रों के संचालन से जुड़ी भारी ऊर्जा और जल की खपत को सीधे तौर पर कम किया जा सकता है।
AGI, लेखकत्व और बौद्धिक संपदा अधिकार
जैसे-जैसे मॉडल्स AGI की ओर बढ़ रहे हैं, ट्रेनिंग डेटा में कॉपीराइट उल्लंघन और बौद्धिक संपदा कानूनों के तहत AI-जनित आविष्कारों की पेटेंट योग्यता से जुड़ी बहसें और तीव्र होंगी।

प्रीलिम्स में Narrow AI बनाम AGI की क्षमताओं के बीच अंतर करने, या 'catastrophic forgetting' जैसे शब्दों को AI प्रणालियों के साथ सुमेलित (match) करने वाले प्रश्न की अपेक्षा करें।
संबद्ध PYQ · 3
संबद्ध PYQ · 3
- 2023MainsGS3
Introduce the concept of Artificial Intelligence (AI). How does Al help clinical diagnosis? Do you perceive any threat to privacy of the individual in the use of Al in healthcare?
- 2021MainsGS3
Discuss how emerging technologies and globalisation contribute to money laundering. Elaborate measures to tackle the problem of money laundering both at national and international levels.
- 2015MainsGS3
What are the areas of prohibitive labour that can be sustainably managed by robots ? Discuss the initiatives that can propel research in premier research institutes for substantive and gainful innovation.
