AI इन्फर्न्स इंजन के लिए DeepSeek की ओपन सोर्स रणनीति
स्रोत:इंडियन एक्सप्रेस ↗
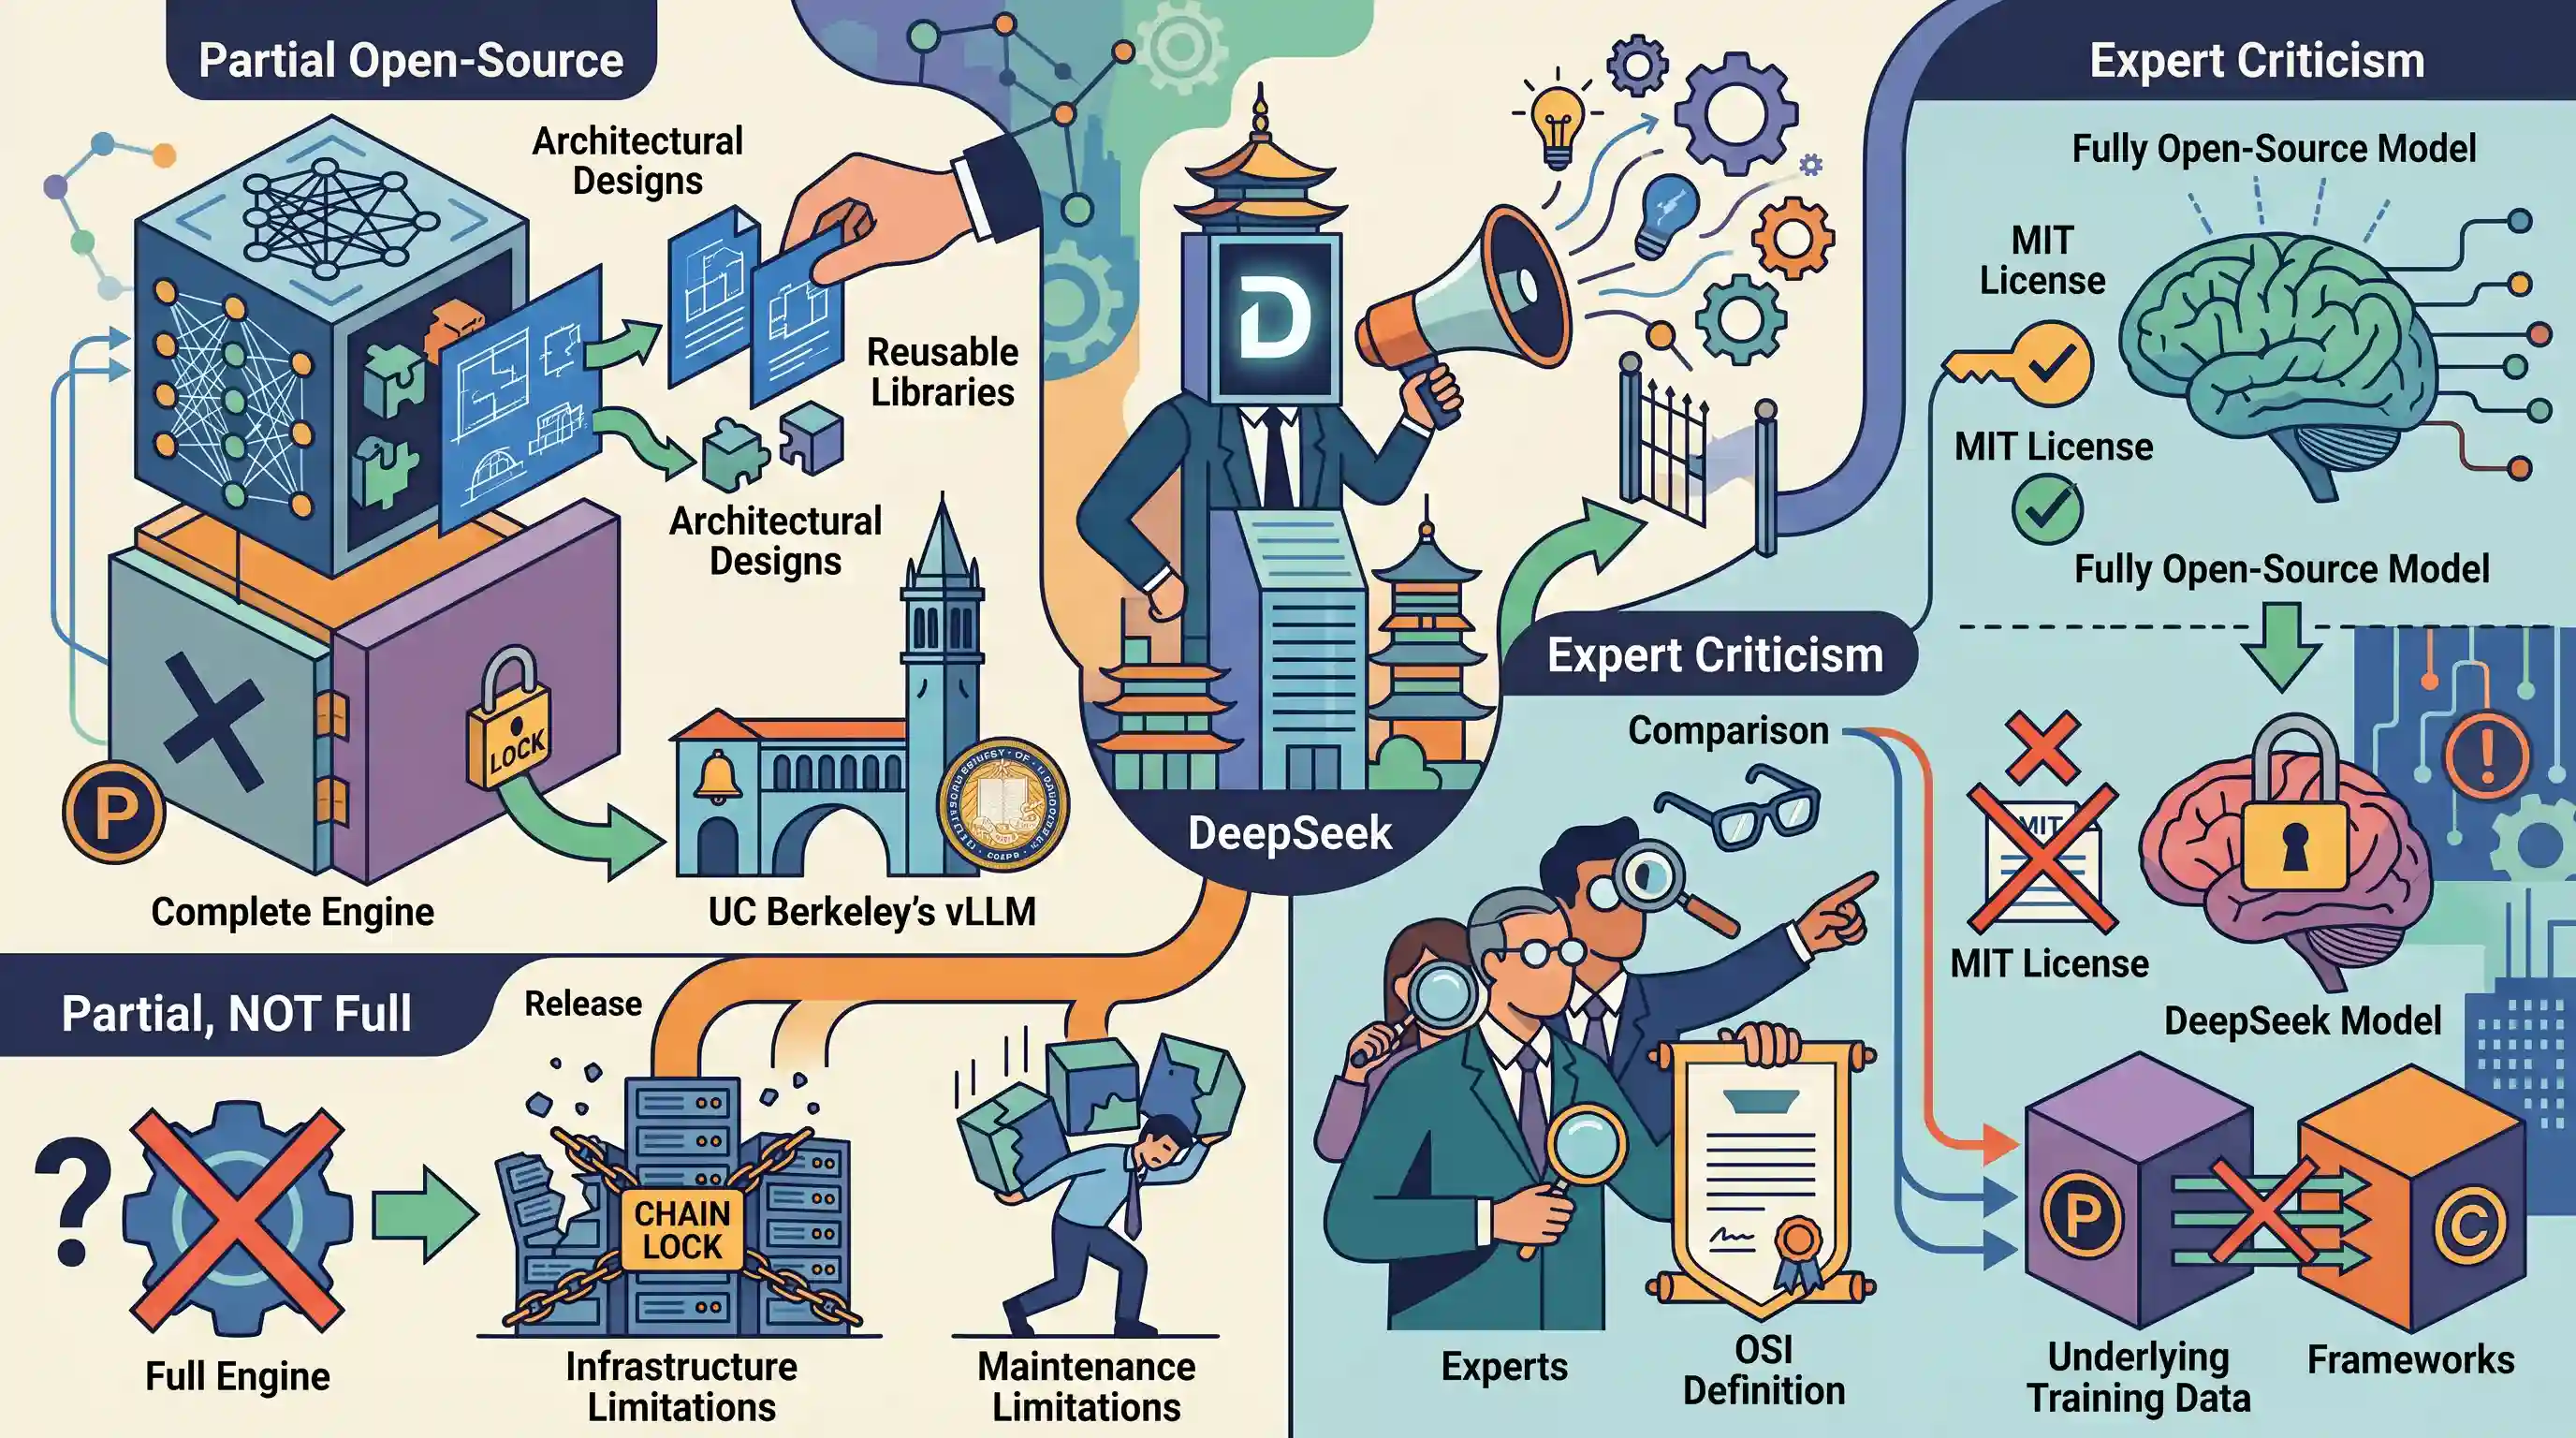
क्यों मायने रखता है
वास्तविक ओपन-सोर्स तकनीक और ओपन-सोर्स तत्वों का उपयोग करने वाले प्रोप्रायटरी मॉडलों के बीच का अंतर वैश्विक AI गवर्नेंस, तकनीक संप्रभुता और डेटा गोपनीयता को समझने के लिए महत्वपूर्ण है। यह ओपन-सोर्स लाइसेंसिंग (जैसे MIT) और OSI मानकों की जटिलताओं को रेखांकित करता है, जो GS3 विज्ञान एवं प्रौद्योगिकी और प्रीलिम्स IT/कंप्यूटर जागरूकता दोनों के लिए प्रासंगिक है।
सारांश
चीनी AI स्टार्टअप DeepSeek ने अपने AI इन्फरेंस इंजन को आंशिक रूप से ओपन-सोर्स करने की घोषणा की है, जिसके तहत वह पूरे इंजन को रिलीज करने के बजाय आर्किटेक्चरल डिज़ाइन और रियूजेबल लाइब्रेरीज़ साझा करेगा। हालाँकि यह UC Berkeley की एक ओपन-सोर्स लाइब्रेरी vLLM का उपयोग करता है, लेकिन इन्फ्रास्ट्रक्चर और रखरखाव संबंधी सीमाओं के कारण इसे पूरी तरह से ओपन-सोर्स रिलीज करना संभव नहीं है। इसके अलावा, तकनीकी विशेषज्ञों का कहना है कि आम धारणा के विपरीत, DeepSeek के मॉडल ओपन सोर्स इनिशिएटिव (OSI) की परिभाषा का पूरी तरह से पालन नहीं करते हैं, क्योंकि इनका अंतर्निहित ट्रेनिंग डेटा और फ्रेमवर्क प्रोप्राइटरी बने हुए हैं और इनमें MIT लाइसेंस जैसे परमिटिव लाइसेंस का अभाव है।
मुख्य बिंदु
- चीनी AI स्टार्टअप DeepSeek अपने AI इन्फरेंस इंजन को पूरी तरह से ओपन-सोर्स करने के बजाय, उसके आर्किटेक्चरल डिजाइन विवरण और स्टैंडअलोन रियूजेबल लाइब्रेरीज़ साझा करने की योजना बना रहा है।
- यह स्टार्टअप अपने AI इन्फ्रेंस के लिए vLLM के एक संशोधित संस्करण का उपयोग करता है, जो UC Berkeley से शुरू हुई एक ओपन-सोर्स लाइब्रेरी है।
- एक पूर्ण ओपन-सोर्स रिलीज़ मेंटेनेंस बैंडविड्थ, इंफ्रास्ट्रक्चरल बाधाओं और अत्यधिक कस्टमाइज्ड कोडबेस के कारण सीमित है।
- DeepSeek के मॉडल, जैसे कि R1, Open Source Initiative (OSI) की ओपन-सोर्स AI की परिभाषा को पूरी तरह से पूरा नहीं करते हैं, क्योंकि ट्रेनिंग डेटा और फ्रेमवर्क जैसे आवश्यक घटकों में 'permissive licenses' का अभाव है।
महत्वपूर्ण शब्द
DeepSeek

एक चीनी आर्टिफिशियल इंटेलिजेंस स्टार्टअप, जो DeepSeek-V3 जैसे उच्च-प्रदर्शन और किफायती मॉडल विकसित करने के लिए जाना जाता है, जो काफी कम ट्रेनिंग लागत पर प्रमुख अमेरिकी AI प्रणालियों को टक्कर देते हैं।
UPSC context
GS Paper 3: विज्ञान एवं प्रौद्योगिकी। AI प्रतिद्वंद्विता, लागत-प्रभावी नवाचार और चीन के बढ़ते तकनीकी प्रभाव के लिए प्रासंगिक।
ओपन सोर्स इनिशिएटिव (OSI)
एक अमेरिकी गैर-लाभकारी संगठन जो 'Open Source Definition' का रखरखाव करता है, जो उन सॉफ्टवेयरों के लिए वैश्विक स्तर पर मान्यता प्राप्त मानक है जिन्हें कानूनी और तकनीकी रूप से ओपन सोर्स के रूप में लेबल किया जा सकता है।
UPSC context
GS पेपर 3: IT और बौद्धिक संपदा अधिकार। यह डिजिटल पब्लिक गुड्स के वैश्विक मानकों के ज्ञान का परीक्षण करता है।
MIT लाइसेंस
एक अत्यंत उदार (permissive) सॉफ्टवेयर लाइसेंस जो उपयोगकर्ताओं को कोड का वाणिज्यिक या निजी उपयोग करने, उसे संशोधित करने और वितरित करने की अनुमति देता है, बशर्ते कि मूल कॉपीराइट नोटिस को इसमें शामिल किया जाए।
UPSC context
GS पेपर 3: बौद्धिक संपदा अधिकार। सॉफ्टवेयर कॉपीराइट मॉडल और ओपन इनोवेशन फ्रेमवर्क को समझने के लिए महत्वपूर्ण।
AI इन्फरेंस
वह प्रक्रिया जिसमें एक पूर्व-प्रशिक्षित (pre-trained) AI मॉडल नए और वास्तविक डेटा (real-world data) पर अपने सीखे हुए पैटर्न को लागू कर आउटपुट (जैसे टेक्स्ट या भविष्यवाणियां) उत्पन्न करता है; यह प्रक्रिया संसाधन-गहन (resource-intensive) ट्रेनिंग चरण से भिन्न होती है।
UPSC context
GS पेपर 3: विज्ञान एवं प्रौद्योगिकी। AI लाइफसाइकिल और प्रौद्योगिकी परिनियोजन में कंप्यूटेशनल दक्षता को समझने के लिए महत्वपूर्ण।
vLLM
एक ओपन-सोर्स लाइब्रेरी (UC Berkeley में विकसित) जिसे उच्च-थ्रूपुट AI मॉडल सर्विंग के लिए अनुकूलित किया गया है, जो इन्फ्रेंस (inference) के दौरान GPU मेमोरी को अधिक कुशलता से प्रबंधित करने के लिए 'PagedAttention' का उपयोग करती है।
UPSC context
GS पेपर 3: IT के क्षेत्र में जागरूकता। यह AI सिस्टम को स्केलेबल और सुलभ बनाने में विशिष्ट तकनीकी प्रगति को दर्शाता है।
प्रारंभिक ट्रैप
AI मॉडल जो अपने ट्रेंड मॉडल वेट्स को स्वतंत्र रूप से जारी करते हैं, वे Open Source Initiative (OSI) के मानदंडों को पूरी तरह से पूरा करते हैं।
वास्तविक ओपन-सोर्स AI के लिए उदार लाइसेंस के तहत सोर्स कोड, फ्रेमवर्क और विस्तृत ट्रेनिंग डेटा तक पहुँच आवश्यक है। केवल मॉडल वेट्स (model weights) जारी करने को "ओपन-वाशिंग" (open-washing) कहा जाता है।
संबंधित अवधारणाएँ
AI Training और AI Inference के बीच तकनीकी अंतर क्या है?
- AI ट्रेनिंग: वह प्रारंभिक शिक्षण चरण जहाँ मॉडल्स पैटर्न को पहचानने और उच्च कंप्यूटेशनल शक्ति (high computational power) के माध्यम से आंतरिक मापदंडों (weights) को समायोजित करने के लिए विशाल डेटासेट को प्रोसेस करते हैं।
- AI इनफरेंस: अनुप्रयोग का वह चरण जहाँ एक प्री-ट्रेंड मॉडल (pre-trained model) नए और अनदेखे डेटा को प्रोसेस करने और रियल-टाइम आउटपुट उत्पन्न करने के लिए सीखे गए तार्किक नियमों को लागू करता है।
ओपन सोर्स सॉफ्टवेयर (OSS) को क्या परिभाषित करता है और भारतीय शासन में इसका उपयोग कैसे किया जाता है?
- मूल दर्शन: ऐसा सॉफ्टवेयर जिसका मूल सोर्स कोड उपयोगकर्ताओं के लिए MIT या Apache जैसे उदार लाइसेंस के तहत देखने, संशोधित करने और वितरित करने के लिए स्वतंत्र रूप से उपलब्ध कराया जाता है।
- कॉपीलेफ्ट बनाम पर्मिसिव: Copyleft (जैसे कि GPL) के तहत यह आवश्यक है कि व्युत्पन्न कार्य (derivative works) भी ओपन-सोर्स हों, जबकि permissive licenses इन्हें प्रोप्रायटरी और क्लोज्ड सॉफ्टवेयर में एकीकृत करने की अनुमति देते हैं।
- भारत द्वारा अपनाया जाना: GoI इंटरऑपरेबिलिटी सुनिश्चित करने और वेंडर लॉक-इन से बचने के लिए OSS को बढ़ावा देती है। आरोग्य सेतु, डिजीलॉकर और CoWIN जैसे प्रमुख प्लेटफॉर्म OSS प्लेटफॉर्म पर आधारित हैं।
अंतर-विषय पैटर्न
ओपन-वॉशिंग बनाम ग्रीन-वॉशिंग प्रतिमान
कॉर्पोरेट ESG दावों में 'ग्रीन-वॉशिंग' (green-washing) की ही तरह, तकनीक के क्षेत्र में 'ओपन-वॉशिंग' (open-washing) में AI मॉडलों को भ्रामक रूप से पूरी तरह से ओपन-सोर्स के रूप में प्रचारित करना शामिल है, जबकि ट्रेनिंग डेटासेट और आर्किटेक्चर जैसे महत्वपूर्ण प्रोपराइटरी (proprietary) घटकों को छिपा लिया जाता है।
भारत के DPI के ओपन-सोर्स आधार
भारत के DPI ढांचे (जैसे ONDC और DIKSHA) काफी हद तक ओपन-सोर्स आधारों पर निर्भर हैं। वास्तविक ओपन-सोर्स AI पर वैश्विक बहस सीधे तौर पर इस बात को प्रभावित करती है कि विकासशील राष्ट्र विदेशी वेंडर लॉक-इन के बिना स्केलेबल डिजिटल गवर्नेंस का निर्माण कैसे करते हैं।
AI ट्रेनिंग डेटा और वैश्विक IPR विवाद
ट्रेनिंग डेटासेट्स को मालिकाना रखना चल रहे वैश्विक IPR संघर्ष को उजागर करता है। AI कंपनियां अक्सर कॉपीराइट वाली डिजिटल सामग्री की अनधिकृत स्क्रैपिंग पर कानूनी जांच से बचने के लिए इन डेटासेट्स को गोपनीय रखती हैं।

2026 की Prelims में AI 'inference' और 'training' के बीच अंतर के साथ-साथ ओपन सोर्स सॉफ्टवेयर (OSS) के मानदंडों (criteria) से संबंधित कथन की अपेक्षा करें।
संबद्ध PYQ · 3
संबद्ध PYQ · 3
- 2022PrelimsGS1
Consider the following : 1. Aarogya Setu 2. CoWIN 3. DigiLocker 4. DIKSHA Which of the above are built on top of open-source digital platforms?
- 2023MainsGS3
Introduce the concept of Artificial Intelligence (AI). How does Al help clinical diagnosis? Do you perceive any threat to privacy of the individual in the use of Al in healthcare?
- 2015MainsGS3
India's Traditional Knowledge Digital Library (TKDL), which has a database containing formatted information on more than 2 million medicinal formulations is proving a powerful weapon in the country's fight against erroneous patents. Discuss the pros and cons of making this database publicly available under open-source licensing.
